Situer les modèles d'IA sur l'échelle
de l'expertise humaine
Mars 2026|Auteur(s) : GPAI Policy Lab
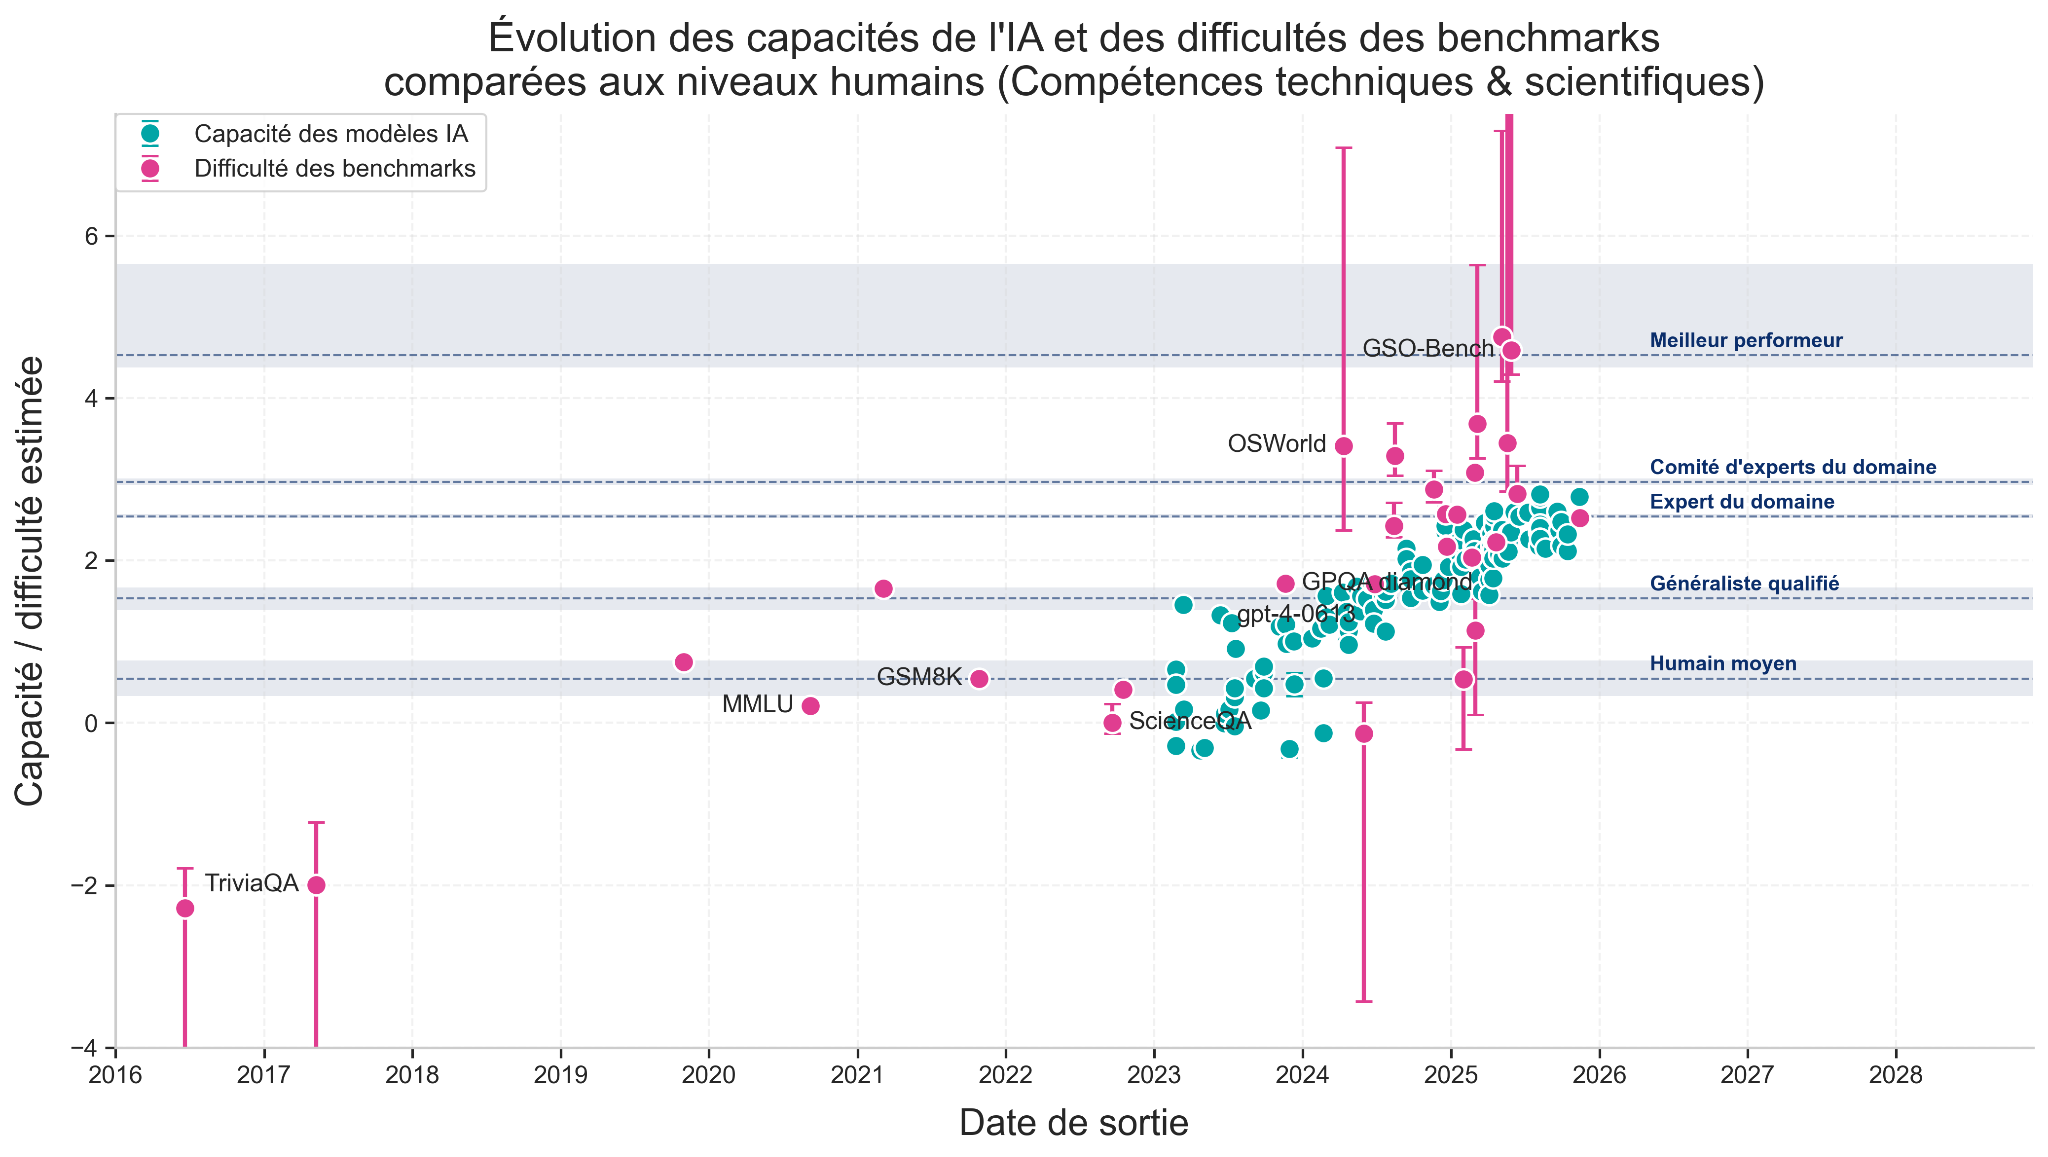
Comment mesurer si une IA a atteint des capacités équivalentes aux experts humains ? Le récent article « Rosetta Stone for AI Benchmarks » (une Pierre de Rosette pour les Benchmarks IA), publié par des chercheurs d'Epoch AI et de Google DeepMind, développe une méthodologie intéressante pour classer les modèles d'IA et les benchmarks sur une échelle de difficulté commune. Mais le « score de capacité » qui en résulte est difficilement interprétable (que veut dire un score de 2,54 ?). Nous avons donc étendu l'approche de Rosetta Stone pour y intégrer des références de performance humaine.
En bref
- Le modèle Rosetta Stone produit, pour chaque modèle d'IA, un score représentant sa capacité à résoudre diverses tâches cognitives. Ces scores permettent de comparer les modèles entre eux, mais ils manquent d'ancrage pour pouvoir les interpréter concrètement.
- Nous proposons de créer cet ancrage en intégrant des références de performance humaine (allant d'humains moyens à des experts de niveau doctorat et aux meilleurs performeurs) directement dans le modèle Rosetta. Cette approche donne ainsi des repères humains concrets à l'échelle de capacité des IA.
- Certains benchmarks ont été spécifiquement conçus pour être faciles pour les humains mais difficiles pour les IA, ce qui invalide l'hypothèse d'un axe unique de capacité/difficulté. Nous avons reproduit l'analyse avec et sans ces benchmarks.
- Résultats principaux :
- En se concentrant sur les benchmarks de compétences techniques et scientifiques, les modèles d'IA de frontière ont déjà dépassé les niveaux Humains Moyens (fin 2022), les Généralistes Qualifiés (début 2024) et les Experts du Domaine (2025) sur le spectre de l'expertise humaine.
- Les modèles futurs devraient atteindre le niveau des Meilleurs Performeurs Humains sur ces tâches techniques d'ici octobre 2027 (IC 95 % : mai 2027 – mars 2028). Cette projection est néanmoins à prendre avec prudence ; les benchmarks restent des approximations imparfaites et les données de référence humaines sont actuellement peu abondantes.
- L'une des principales limites de cette analyse est le manque de cohérence dans la collecte des données de performance humaines à différents niveaux de difficulté. Il est nécessaire de collecter davantage de références humaines standardisées à travers les différents niveaux de difficulté pour rendre ce type de calibration plus robuste, ainsi que des benchmarks plus difficiles pour mieux estimer le plafond de performance humaine.
Contexte : Comparer les progrès de l'IA aux performances humaines
Brève introduction : Le modèle de Rosetta Stone
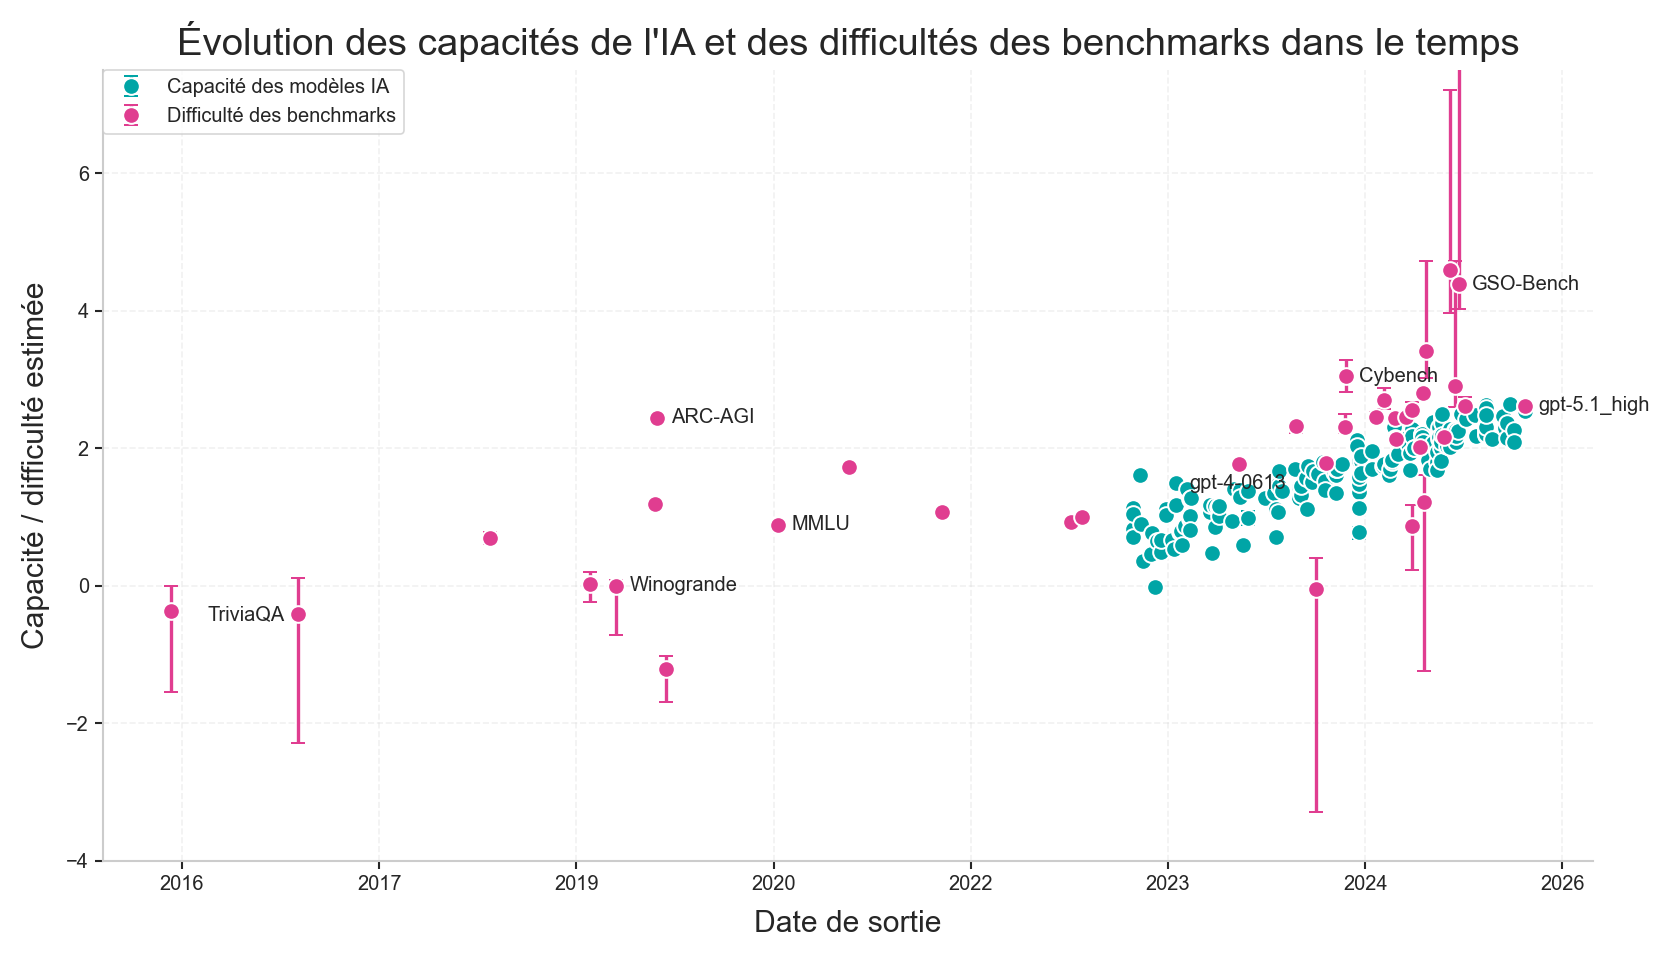
Le rythme du développement de l'IA est souvent rapporté à travers ses composantes techniques : plus de paramètres, plus de FLOPs, ou des scores plus élevés sur des benchmarks spécifiques. Notre travail s'appuie directement sur le modèle Rosetta Stone (étroitement lié à l'Epoch Capabilities Index), qui s'inscrit dans cette lignée : l'article original a introduit une méthode pour estimer et comparer la capacité de différents modèles d'IA en fonction de leur facilité à résoudre des benchmarks à différents niveaux de difficulté. Ces capacités estimées correspondent globalement à l'intuition des utilisateurs concernant le classement des modèles, comme le montre le graphique clé reproduit ci-dessous (Figure 1 de l'article original).
Ce graphique montre visuellement le classement relatif des modèles et des benchmarks au fil du temps. Cette forme de classement « universel » permet de comparer les capacités de modèles qui n'ont jamais été testés les uns contre les autres, aussi bien que les difficultés de benchmarks tels qu'un examen de chimie de niveau doctorat versus des tâches de cybersécurité. Les benchmarks (en rose) qui n'ont pas encore été saturés sont visibles au-dessus du nuage de modèles (en bleu-vert).
Ajouter des références humaines à Rosetta
Savoir que Gemini 2.5 Pro a une « capacité de 2,54 » n'est pas significatif en soi. L'article Rosetta Stone propose d'interpréter les scores des modèles en examinant les différences relatives entre modèles et en reliant leurs capacités aux horizons temporels des tâches que les modèles peuvent réaliser (en se basant sur les travaux de l'organisation METR). Nous poursuivons cette démarche en intégrant des scores humains issus de la littérature (c'est-à-dire les scores obtenus par des humains sur les mêmes benchmarks utilisés pour évaluer les IA) pour ancrer ces scores à des niveaux d'expertise concrets comme points de référence.
Le modèle Rosetta repose sur l'hypothèse qu'un facteur de capacité commun sous-tend toutes les tâches et que tous les modèles peuvent être placés sur cette dimension. En traitant les groupes d'expertise humaine comme des « modèles » dans la base de données Rosetta, nous pouvons calibrer cet axe et évaluer la position d'un modèle par rapport, par exemple, à un spécialiste de niveau doctorat.
Un seul axe ?
Cette hypothèse n'est valide qu'en première approximation. La comparaison entre modèles révèle des différences au-delà d'un seul axe de capacité (voir Benchmark Scores = General Capability + Claudiness), et cet effet est renforcé par l'avancée hétérogène des performances de l'IA par rapport aux capacités humaines (jagged frontier). Les humains présentent une hiérarchie de compétences prévisible : si une personne peut résoudre un problème de chimie de niveau doctorat, on peut raisonnablement supposer qu'elle peut aussi répondre à une question de bon sens. Les modèles d'IA ne partagent pas cette hiérarchie et inversent régulièrement cet ordonnancement.
Cela crée un problème structurel pour le modèle :
- Certains benchmarks (comme HellaSwag ou ARC-AGI) ont été conçus spécifiquement pour être triviaux pour les humains mais difficiles pour l'IA, tandis que les benchmarks techniques avancés (GPQA Diamond, FrontierMath) sont difficiles pour les deux.
- Quand on introduit des benchmarks faciles pour les humains mais difficiles pour l'IA, l'hypothèse d'un axe de difficulté unifié n'a plus de sens pour comparer les performances humaines et IA.
- Parce que l'implémentation actuelle de Rosetta ne prend pas encore en charge des axes de capacité multidimensionnels, et que de nombreuses données humaines sont disponibles pour ces benchmarks spécifiquement faciles pour les humains, les Humains Moyens apparaissent bien plus « capables » qu'ils ne le sont par leur placement comparatif avec les benchmarks techniques.
Les auteurs de l'article Rosetta Stone reconnaissent cette limitation et le fait que l'intégration d'axes de difficulté multiples est une extension naturelle de leur cadre. Pour l'instant, nous filtrons les benchmarks pour lesquels l'axe de difficulté humaine et l'axe de difficulté IA sont raisonnablement alignés : principalement les tâches techniques et scientifiques. 8 benchmarks sur 38 sont ainsi retirés de l'analyse principale. Nous avons inclus les résultats complets, non filtrés, en Annexe 3.
Résultats : Ancrer Rosetta Stone avec des références humaines
Nous avons catégorisé les références humaines en quatre niveaux distincts (voir la méthodologie complète en Annexe 1), plus une version agrégée « Comité » pour les catégories d'experts :
- Humain Moyen : Travailleurs participatifs (ex. MTurk) ou participants non spécialisés.
- Généraliste Qualifié : Individus avec une formation avancée mais hors du domaine cible (ex. doctorants dans des domaines non liés, professionnels qualifiés).
- Expert du Domaine : Spécialistes de niveau doctorat dans le domaine concerné ou professionnels experts.
- Meilleur Performeur : Performeurs d'élite (ex. mathématiciens médaillés Fields, top 5 % des meilleurs résultats aux tests ou meilleur résultat).
- Comités : Votes majoritaires agrégés ou scores moyens d'équipe pour les groupes ci-dessus.
Échelle humaine calibrée
Lorsque les benchmarks techniques et scientifiques sont isolés pour aligner la difficulté humaine et IA, une hiérarchie attendue émerge :
| Groupe | Capacité estimée |
|---|---|
| Humain Moyen | 0.55 |
| Généraliste Qualifié | 1.54 |
| Expert du Domaine | 2.54 |
| Comité d'Experts du Domaine | 2.97 |
| Meilleur Performeur | 4.53 |
Pour contexte, les Généralistes Qualifiés, avec un score de capacité de 1,54, se situent juste en dessous de Claude 3 Opus. Les Experts du Domaine se placent à 2,54, au niveau de Gemini 2.5 Pro. Le Comité d'Experts du Domaine et les Meilleurs Performeurs obtiennent tous deux des scores supérieurs à GPT-5, actuellement le modèle le plus performant de la base de données Rosetta à 2,81.
Classement actuel : Modèles vs. Experts
En 2026, les modèles de frontière ont déjà franchi les seuils des Humains Moyens (fin 2022), des Généralistes Qualifiés (début 2024) et des Experts du Domaine (2025). Les modèles de frontière actuels se rapprochent du niveau Comité d'Experts du Domaine : leurs performances sont presque au niveau de celles d'équipes professionnelles en collaboration sur des tâches techniques bien définies.
Deux des benchmarks les plus difficiles sont GSO-Bench et FrontierMath, qui visent respectivement à tester l'optimisation logicielle (amélioration de l'efficacité d'exécution du code par rapport aux solutions de développeurs experts) et à évaluer des problèmes mathématiques de niveau recherche nécessitant souvent des heures de coopération entre experts pour être résolus. Ces benchmarks approchent les standards professionnels réels, bien que dans des cadres simplifiés, indiquant que si les modèles actuels atteignent le niveau des Comités d'Experts, la performance individuelle d'élite reste hors de portée des capacités actuelles.
Ce que ces résultats montrent, c'est que les modèles sont de plus en plus capables de résoudre les types de problèmes techniques et à réponse déterminée que les experts résolvent, dans des conditions contrôlées, ce qui est déjà remarquable.
Projections : Quand l'IA dépassera-t-elle les seuils experts ?
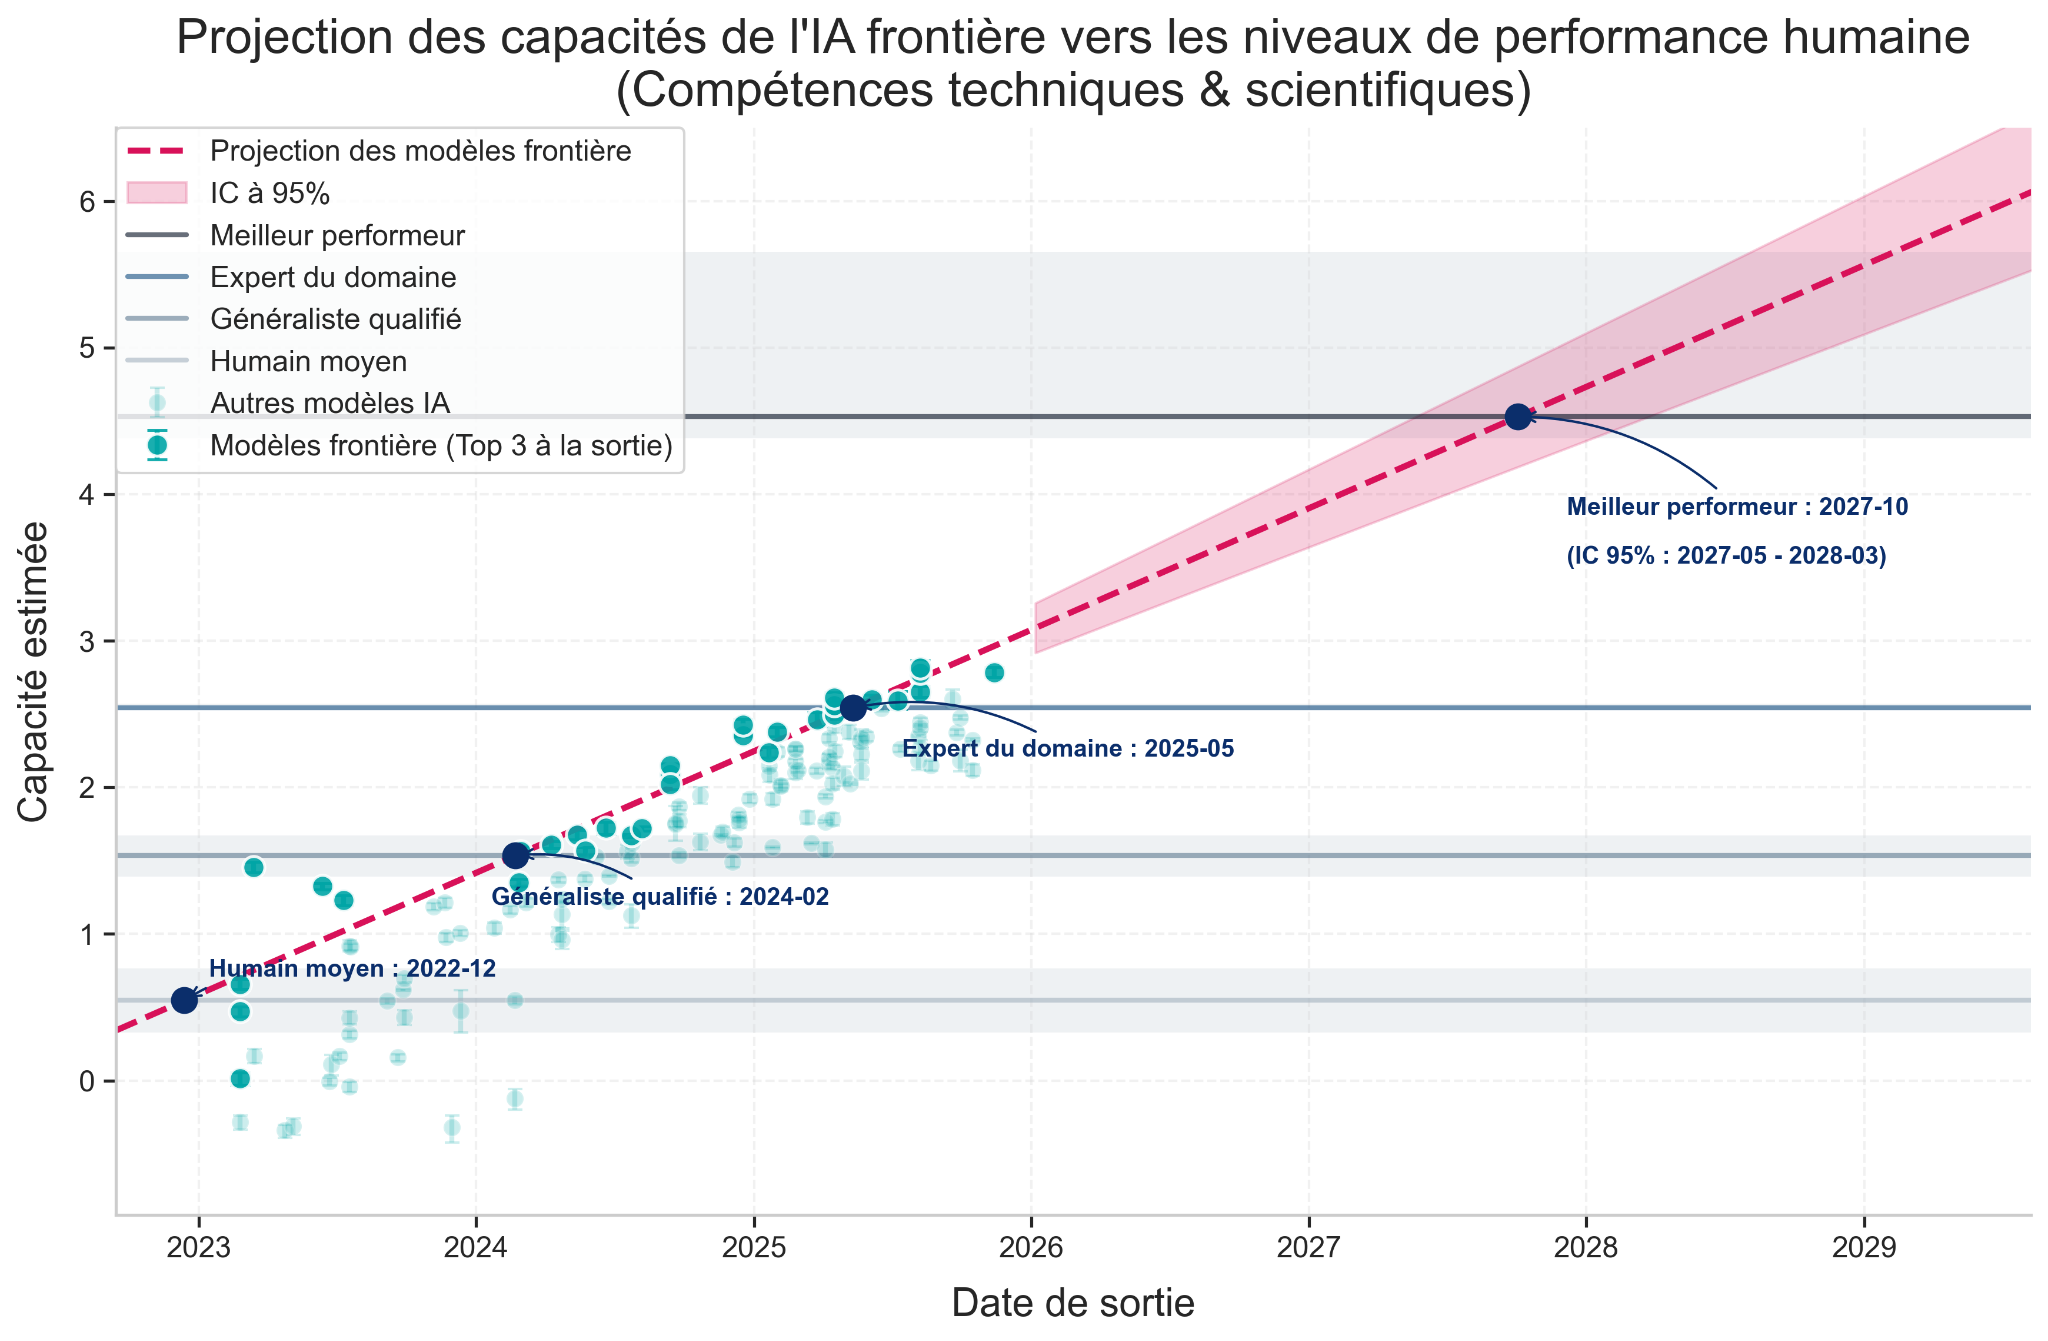
En extrapolant linéairement les capacités des modèles dans le top-3 à leur date de publication, on obtient une estimation des dates de parité en IA et experts humains. À noter, ces projections supposent une continuation des tendances actuelles et ne tiennent pas compte d'autres variables :
- Parité avec l'Humain Moyen : décembre 2022.
- Parité avec le Généraliste Qualifié : février 2024.
- Parité avec l'Expert du Domaine : mai 2025.
- Parité avec le Meilleur Performeur : Cette référence représente un saut significatif en performance, et dans la projection, les modèles atteignent ce niveau aux alentours d'octobre 2027 (intervalle de confiance à 95 % : mai 2027 – mars 2028, sans prendre en compte l'incertitude sur le seuil de performance des meilleurs performeurs).
Motivation pour davantage de données
La première limite de cette analyse est la rareté des données ; la plupart des groupes humains ne disposent que de 2 à 4 points de données chacun, et généralement les données ne couvrent pas les scores d'un groupe en dehors de son domaine d'expertise principal. Pour améliorer les prédictions, il serait nécessaire de disposer d'une cartographie plus exhaustive des performances humaines à travers les niveaux de difficulté pour des ensembles distincts de compétences (ex. techniques, sens commun). Concrètement :
- Des experts sur des benchmarks faciles et moyens, pour établir un plafond de capacité.
- Des Humains Moyens sur des benchmarks difficiles, pour ancrer l'extrémité inférieure de l'échelle de capacité sur les tâches difficiles.
- Une couverture cohérente entre les catégories de compétences (ex. techniques, sens commun, raisonnement visuel).
Limites
Limites des références humaines
Contrairement aux évaluations de modèles, les scores humains proviennent d'études avec des conditions très variables : des tailles d'échantillon (des milliers de travailleurs participatifs contre une poignée d'experts), des incitations, des limites de temps, jusqu'à un accès différent aux outils. Ce bruit se combine aux effets de plafond sur les benchmarks faciles ainsi qu'au manque de données pour chaque niveau d'expertise.
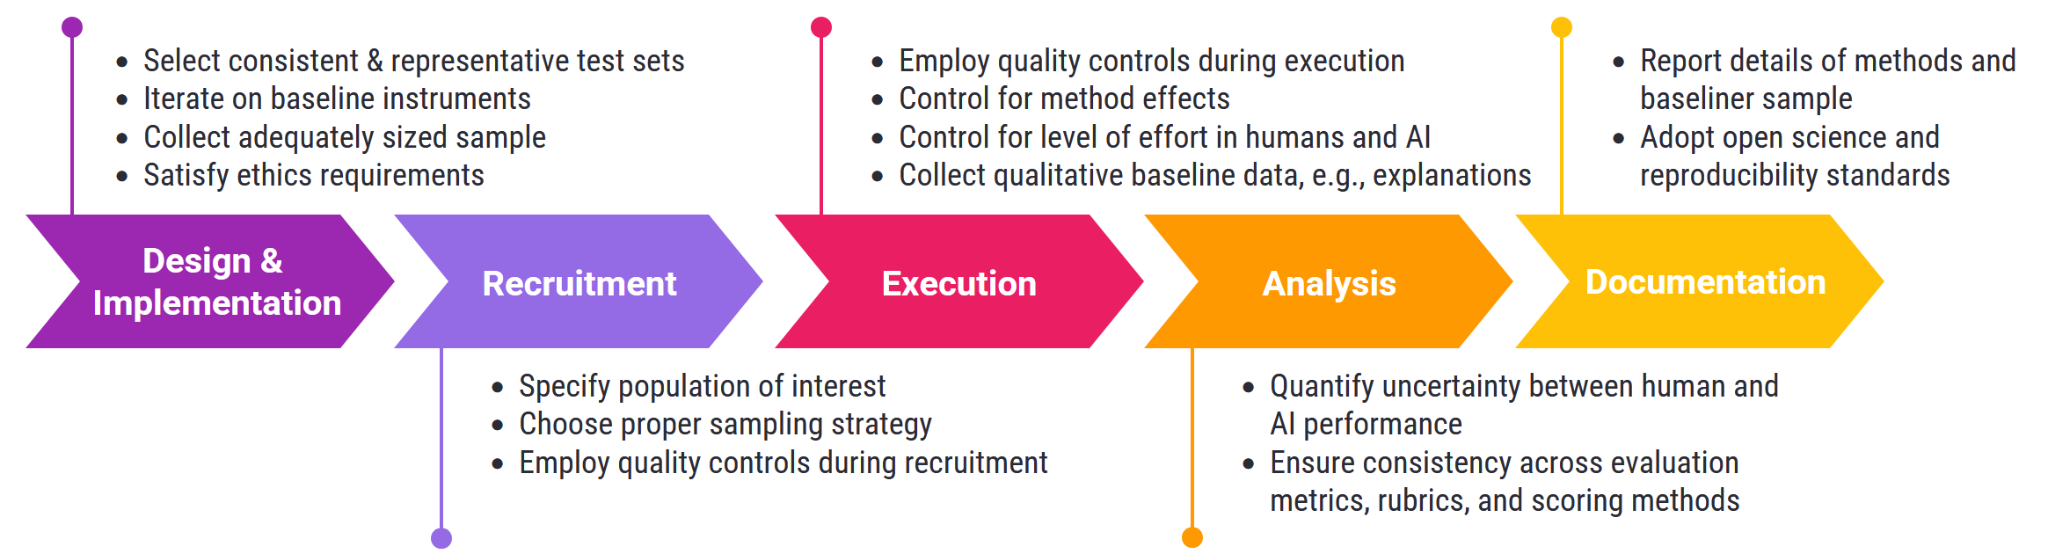
Wei et al. (ICML 2025) font un constat similaire : les références humaines existantes dans les évaluations de modèles ne sont ni suffisamment rigoureuses ni suffisamment bien documentées pour soutenir de manière robuste les comparaisons entre humains et IA. Leur liste de vérification recommandée offre un standard utile pour des métadonnées humaines mieux structurées.
Limites du modèle à axe unique
La deuxième limitation majeure est le modèle à simple axe de difficulté. Rosetta suppose une dimension de capacité sous-jacente unique, mais le problème de jagged frontier suggère des axes multiples : connaissances techniques/factuelles, bon sens, raisonnement fluide, a priori culturels, etc. Par exemple, Burnell et al. (2023), Maia Polo et al. (2025), Kipnis et al. (2025) et Ruan et al. (2024) identifient des compétences latentes de faible dimension telles que le raisonnement, la modélisation du langage et le suivi d'instructions. Étendre Rosetta pour gérer des axes de difficulté multiples permettrait de représenter et comprendre les capacités de l'IA de manière plus fidèle. Les auteurs reconnaissent cela comme l'évolution naturelle de l'analyse, et nous travaillons actuellement sur cette extension multi-axes de l'échelle de difficulté.
Travaux futurs
Au-delà de ces deux aspects, d'autres directions méritent d'être explorées :
- Élargir la couverture des benchmarks - aux domaines professionnels (finance, droit, médecine, informatique) où des données de performance humaine en conditions réelles existent. Décomposer les résultats par domaine (mathématiques, programmation, biologie, etc.) révélerait également où les modèles de frontière ont véritablement franchi le niveau expert par rapport aux domaines où le score agrégé gonfle leur classement.
- Des benchmarks plus difficiles et plus réalistes - les modèles saturent les benchmarks existants plus vite que de nouveaux n'apparaissent. Nous avons besoin de benchmarks comme le Remote Labor Index pour représenter des tâches professionnelles sous des contraintes réelles, capables de discriminer à la frontière.
- Des niveaux d'expertise humaine plus fins - la distinction de capacité entre un doctorant et un chercheur avec des années d'expérience, par exemple, nécessiterait des données plus systématiquement identifiées, mais clarifierait significativement le sommet de l'échelle humaine.
- Scores de comités et de collaborations - les références individuelles d'experts ne constituent pas un plafond de ce que les humains peuvent accomplir. Des données systématiques sur la performance de petits groupes donneraient une borne supérieure plus honnête de la capacité humaine à mesure que les systèmes d'IA sont de plus en plus comparés à des équipes plutôt qu'à des individus.
Annexe 1 - Méthodologie complète
Nous étendons Rosetta en ajoutant des groupes de référence humains sur le même système de coordonnées et en les traitant comme des pseudo-modèles dans la base de données. Les références humaines sont dérivées des scores rapportés dans la littérature sur les mêmes benchmarks utilisés pour évaluer les modèles d'IA (voir Annexe 2). Nous les avons catégorisées en quatre niveaux distincts, plus une version agrégée « Comité » pour les catégories d'experts :
- Humain Moyen : Travailleurs participatifs (ex. MTurk) ou participants non spécialisés.
- Généraliste Qualifié : Individus avec une formation avancée mais hors du domaine cible.
- Expert du Domaine : Spécialistes de niveau doctorat dans le domaine concerné ou professionnels experts.
- Meilleur Performeur : Performeurs d'élite (ex. mathématiciens médaillés Fields, 5 % des meilleurs résultats).
- Comités : Votes majoritaires agrégés ou scores moyens d'équipe pour les groupes ci-dessus.
Cette structure à quatre niveaux émerge naturellement de la littérature existante ; les chercheurs rapportent généralement les scores avec des descriptions minimales. De nombreux benchmarks techniques sont évalués contre des spécialistes de niveau doctorat ou des individus de niveau doctorat dans des domaines non liés. Parallèlement, une autre large part de la littérature des benchmarks fait appel à des travailleurs participatifs ou des participants non spécialisés, largement catégorisés comme Humains Moyens. Au-delà de ces trois niveaux, un petit nombre de scores exceptionnels se situent au-dessus du niveau expert typique sans appartenir à une catégorie de qualification clairement distincte. Ceux-ci définissent la frontière de la performance humaine, reflétant probablement une combinaison de maîtrise du domaine, d'aptitude aux tests et de familiarité avec le format du benchmark. Une résolution plus fine distinguant, par exemple, un doctorant de deuxième année d'un chercheur senior serait utile, mais la littérature actuelle ne fournit pas encore suffisamment de données labellisées de manière homogène pour l'appuyer.
Choix méthodologiques
- Retrait des benchmarks intentionnellement faciles pour les humains : ARC-AGI, TriviaQA, HellaSwag, OpenBookQA, PIQA, SimpleBench, VPCT et WinoGrande ont été entièrement retirés de la base de données Rosetta, scores inclus. Les conserver même sans les scores aurait faussé à la fois les estimations de capacité et le positionnement pour le reste des benchmarks. Avec ce changement, l'« ancre » de difficulté des benchmarks définissant le zéro a été changée de WinoGrande à ScienceQA (qui avait un score de difficulté de 0,776).
- Introduction de PRBench Finance : Nous avons intégré PRBench Finance comme cas test pour étendre la base de données Rosetta au-delà de son ensemble de benchmarks original. PRBench Finance reflète des tâches financières professionnelles en conditions réelles et permet d'ajouter des points de données pour la référence du Comité d'Experts du Domaine.
- Calcul de l'incertitude : Nous suivons la méthode de l'article original. La marge d'erreur entourant les références et les modèles (représentée par un intervalle de confiance à 95 %) reflète l'incertitude inhérente aux tests sur un ensemble fini de benchmarks ; elle est définie en calculant de combien un score de capacité peut être déplacé avant de provoquer une augmentation de 5 % de la fonction de perte du modèle.
- Projection des dates de parité : Les dates de parité sont des extrapolations linéaires à partir des scores de capacité des 3 meilleurs modèles de frontière au fil du temps, en supposant que le progrès des capacités continue sur sa trajectoire actuelle.
Annexe 2 - Références humaines (compétences techniques et scientifiques)
| Benchmark | Groupe humain | Score | Source |
|---|---|---|---|
| FrontierMath 2025 | Comité d'Experts du Domaine | 0.35 | FrontierMath | Epoch AI |
| PRBench Finance | Comité d'Experts du Domaine | 0.796 | PRBench |
| GPQA Diamond | Expert du Domaine | 0.812 | GPQA |
| GPQA Diamond | Généraliste Qualifié | 0.219 | GPQA |
| GPQA Diamond | Expert du Domaine | 0.697 | GPQA Diamond | Epoch AI |
| GSM8K | Généraliste Qualifié | 0.968 | GSM8K |
| GeoBench | Meilleur Performeur | 0.9 | GeoBench |
| MATH level 5 | Meilleur Performeur | 0.9 | MATH (tous niveaux) |
| MATH level 5 | Généraliste Qualifié | 0.4 | MATH (tous niveaux) |
| MMLU | Expert du Domaine | 0.898 | MMLU |
| MMLU | Humain Moyen | 0.345 | MMLU |
| ScienceQA | Humain Moyen | 0.884 | ScienceQA |
| OSWorld | Généraliste Qualifié | 0.724 | OSWorld |
| TriviaQA | Humain Moyen | 0.797 | TriviaQA |
Benchmarks spécifiquement faciles pour les humains
| Benchmark | Groupe humain | Score | Source |
|---|---|---|---|
| ARC AGI 1 | Humain Moyen | 0.77 | ARC Prize |
| ARC AGI 1 | Comité d'Humains Moyens | 0.98 | ARC Prize |
| ARC AGI 1 | Comité de Généralistes Qualifiés | 0.98 | ARC Prize |
| HellaSwag | Comité d'Humains Moyens | 0.956 | HellaSwag |
| OpenBookQA | Humain Moyen | 0.92 | OpenBookQA |
| PIQA | Comité de Généralistes Qualifiés | 0.949 | PIQA |
| SimpleBench | Humain Moyen | 0.837 | SimpleBench |
| VPCT | Humain Moyen | 1 | VPCT | Epoch AI |
| WinoGrande | Comité d'Humains Moyens | 0.94 | WinoGrande |
Annexe 3 - Tous les benchmarks inclus
L'inclusion de tous les benchmarks casse immédiatement les intuitions du modèle : la référence humain moyen apparaissait disproportionnellement capable, avec une capacité estimée même supérieure à celle des Experts du Domaine et des Généralistes Qualifiés. La plupart des scores contribuant à la référence humain moyen proviennent de benchmarks de bon sens (faciles pour les humains, historiquement difficiles pour l'IA). Ils sont testés sur des tâches qui rapportent beaucoup de points dans la pondération de difficulté du modèle. À l'inverse, les Généralistes Qualifiés sont presque exclusivement testés sur des benchmarks scientifiques difficiles (ex. GPQA Diamond) où ils obtiennent naturellement des scores inférieurs aux Experts du Domaine et aux meilleurs performeurs. Parce que le graphique Rosetta établit la difficulté par rapport aux difficultés que l'IA a pour résoudre une tâche, la haute performance des humains moyens sur les tâches de sens commun « difficiles pour l'IA » par exemple gonfle leur capacité perçue.
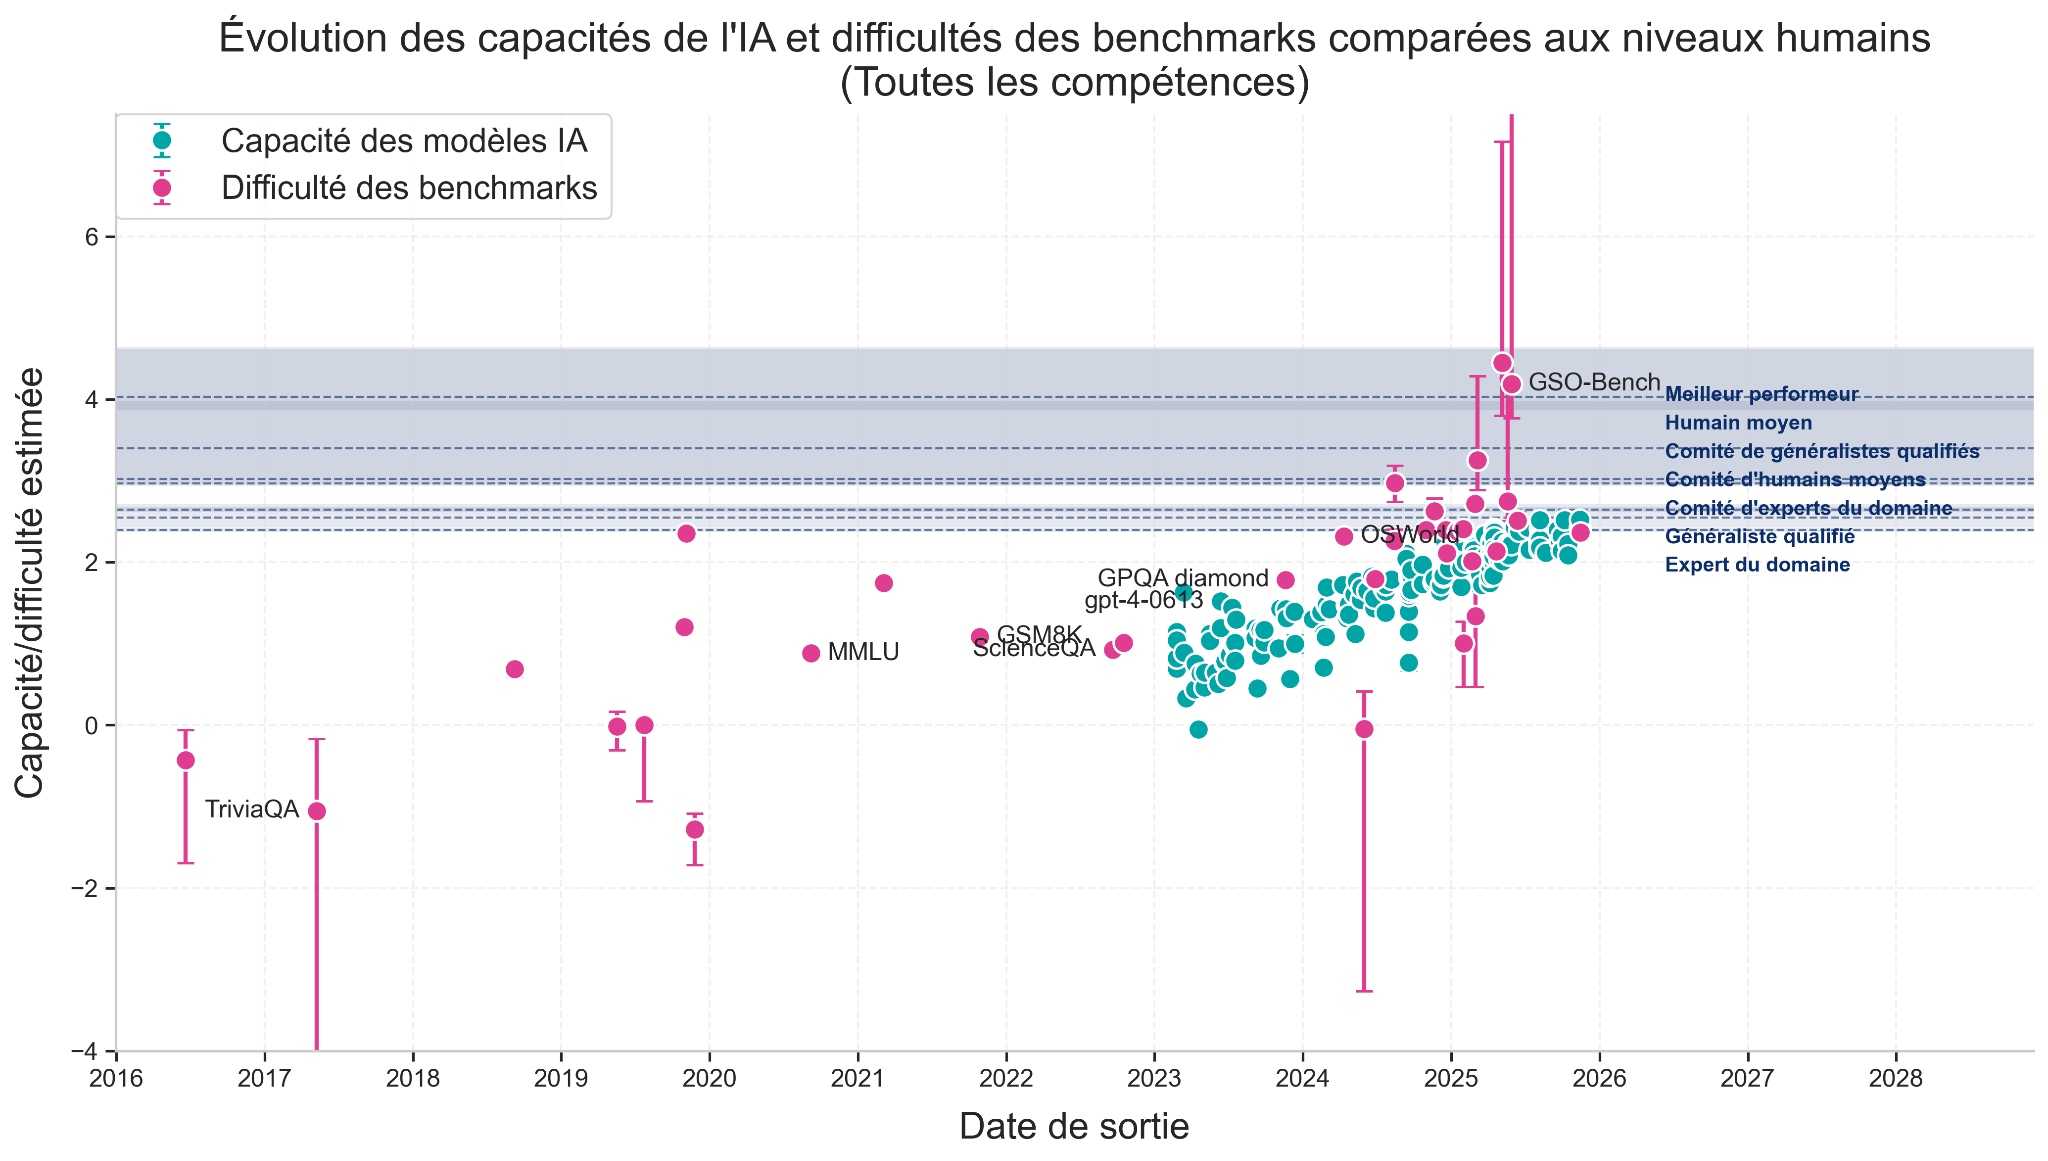
Expérience supplémentaire : Simulation de données artificielles
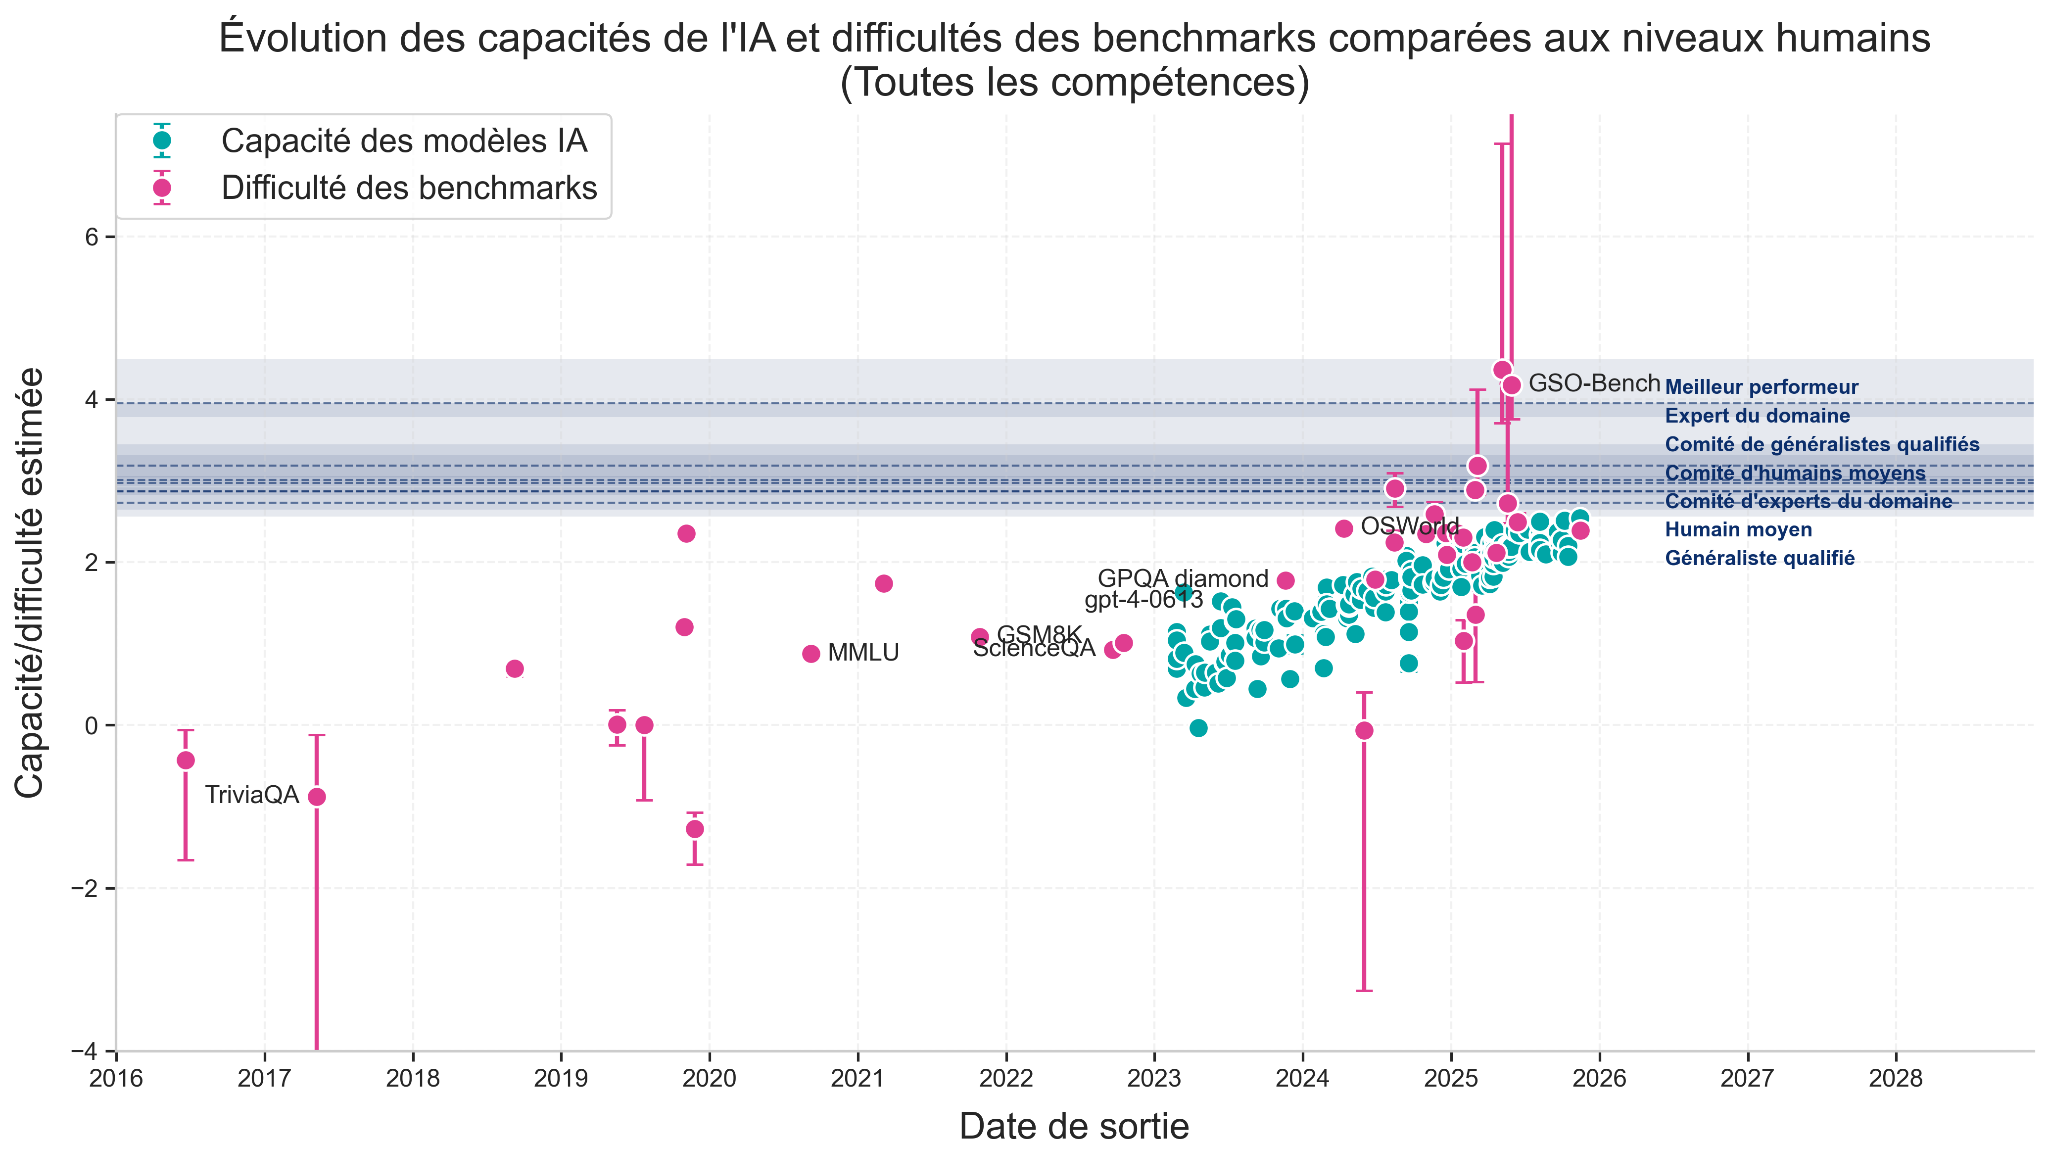
Nous avons réalisé une analyse séparée sur l'ensemble complet de benchmarks, benchmarks faciles pour les humains inclus, en ajoutant manuellement des estimations de scores extrapolés :
- Si les Humains Moyens obtiennent > 90 % sur un benchmark (ex. WinoGrande, VPCT), nous attribuons un score de 100 % aux Généralistes Qualifiés et aux Experts pour cette même tâche.
- Ces données artificielles sont des estimations grossières ; les valeurs exactes ne sont pas primordiales. L'objectif est de simuler à quoi ressemblerait la collecte de références humaines avec une couverture de données plus uniforme.
En résultat, la plupart des groupes experts reviennent au-dessus de la référence Humain Moyen. La capacité estimée de l'Humain Moyen reste plus élevée qu'elle ne devrait l'être. L'anomalie est probablement encore due à des données manquantes ; nous n'avons pas de scores d'Humains Moyens sur les benchmarks difficiles, donc le modèle ne peut pas les placer correctement. Davantage de données dans la bonne structure résoudraient probablement ce problème.
Citer ce billet
GPAI Policy Lab. « Situer les modèles d'IA sur l'échelle de l'expertise humaine. » Mars 2026. https://gpaipolicylab.org/blog-1.