Évaluation des IA de frontière — des difficultés croissantes
Cette note vise à répondre à trois questions :
- Quelles sont les spécificités du domaine de l’évaluation de l’IA ?
- À quelles difficultés les évaluateurs font-ils face, et devront-ils faire face de manière croissante dans les années à venir ?
- Quelles leçons peut-on en tirer pour l’évaluation et la sécurité des IA à usage général ?
I. Quelles sont les spécificités du domaine de l’évaluation de l’IA ?
1. Les capacités des IA ne peuvent pas être anticipées précisément avant de réaliser les évaluations
Les développeurs d’IA à usage général de frontière ne contrôlent pas les capacités et comportements exacts des IA qu’ils entraînent, et se reposent donc sur des évaluations. Le développement de logiciels classiques inclut des phases de test durant lesquelles les développeurs traquent les failles pour que le logiciel se comporte comme prévu. Les IA modernes ne sont toutefois pas programmées directement : elles sont entraînées suivant un processus itératif empirique sur des corpus massifs. Ce processus produit des « boîtes noires » qui généralisent efficacement, mais de façon imprévisible, à des situations jamais rencontrées. Il n’est donc pas possible de connaître avant l’évaluation les connaissances et capacités acquises. L’évaluation mesure à la fois ce qui a été appris et la robustesse face aux interactions des utilisateurs.
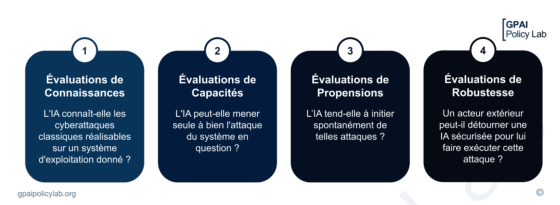
Les évaluations prennent le plus souvent la forme de benchmarks quantitatifs et statiques : des ensembles de questions ou de tâches fixées à l’avance, qui ne s’adaptent pas au système évalué, et qui mesurent si une réponse pré-enregistrée est obtenue plutôt que la manière dont elle l’est. On distingue quatre domaines : connaissances, capacités, propensions (tendances à adopter certains comportements) et robustesse.
Encadré 1 — Exemples d’évaluations
Évaluations de robustesse aux attaques adversariales. Une attaque adversariale provoque un comportement non désiré par les développeurs. Les jailbreaks cherchent par exemple à obtenir des réponses injurieuses ou des informations dangereuses. Comme chaque IA a été entraînée contre des attaques différentes et que de nouveaux jailbreaks apparaissent régulièrement, un benchmark statique ne peut pas mesurer durablement cette robustesse. Des benchmarks dynamiques identifient automatiquement de nouvelles attaques ; on mesure plutôt la facilité avec laquelle un jailbreak peut être découvert.
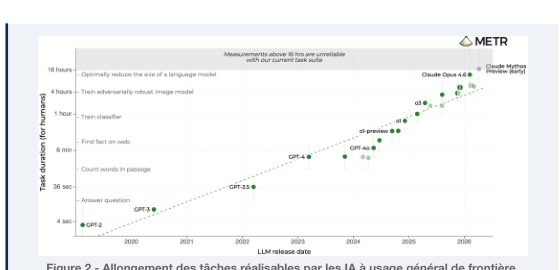
Évaluations de capacités. L’article Task-Completion Time Horizons of Frontier AI Models de METR mesure la capacité à exécuter des tâches de code autonomes avec 50 % de chance de succès, en la comparant au temps d’un expert humain. Il comporte 170 tâches, de quelques secondes à une trentaine d’heures pour un expert, effectuées par plus de 800 professionnels. Claude Mythos Preview atteint au moins 16 heures de temps humain équivalent, à la limite de mesure fiable du benchmark.
2. La faisabilité et la crédibilité des évaluations découlent de l’accessibilité aux modèles et aux benchmarks
Les évaluations réalisables dépendent fortement de l’accès aux IA de pointe, qui n’est pas toujours fourni aux évaluateurs. Les évaluations white-box demandent l’accès complet au modèle et à ses paramètres, notamment pour tester sa robustesse à des données additionnelles (fine-tuning). Les instituts partenaires — UK AI Security Institute, US Center for AI Standards and Innovation, METR ou Apollo Research — reçoivent un accès précoce essentiellement black-box, et ponctuellement grey-box, sans disposer des poids ni d’un fine-tuning illimité.
Les entreprises imposent régulièrement des délais très courts, nuisant à la rigueur technique et scientifique. La dépendance envers des entreprises qui peuvent révoquer l’accès compromet l’indépendance et la pertinence des évaluations. Les autres acteurs doivent se contenter d’évaluations black-box après le déploiement public, ou de white-box sur des systèmes open source en retard sur l’état de l’art.
Un benchmark ouvert est vérifiable et reproductible, mais son contenu peut contaminer les données d’entraînement et perdre son utilité. Un benchmark fermé préserve la mesure des progrès, mais il est plus difficile de lui accorder de la crédibilité, surtout lorsqu’il est développé par une entreprise pour ses propres systèmes.
Régimes d’évaluation
Benchmarks ouverts : reproductibles et comparables, mais exposés à la contamination. Évaluations internes : accès aux derniers modèles, avec un risque de conflit d’intérêts.
Audits externes mandatés : indépendance forte mais accès souvent tardif. Benchmarks privés : accès aux modèles récents, mais opacité et conflits d’intérêts.
Les entreprises peuvent enfin corriger superficiellement leurs modèles à partir du travail des évaluateurs (« dirty patching »), donnant une illusion de sécurité sans résoudre les vulnérabilités sous-jacentes. Il n’existe pas aujourd’hui de mesure commune de la rigueur des évaluateurs ni de leur capacité à limiter ces fuites d’information.
II. Évaluer les IA de frontière devient de plus en plus difficile
L’évaluation des IA souffre de problèmes méthodologiques qui montrent qu’elle n’est pas encore une science robuste. Les principales difficultés actuelles vont croître avec les capacités des modèles.
1. Les problèmes classiques de l’évaluation par benchmarks
- Contamination des données. La part des données d’un benchmark déjà présente dans l’entraînement peut être estimée en modifiant légèrement les questions. On estime ainsi que 25 % de HumanEval était mémorisé par GPT-4 ; Common Crawl contient au moins 29 % de MMLU. Ces méthodes ne détectent cependant que la mémorisation explicite.
- Saturation. Quand les modèles répondent correctement à la plupart des questions, un benchmark ne mesure plus les performances réelles et ne différencie plus les modèles. GPT-5.4 Pro et Gemini 3.1 Pro obtiennent respectivement 94,6 % et 94,1 % à GPQA Diamond ; presque tous les benchmarks cognitifs actuels devraient être saturés d’ici 2030.
- Erreurs humaines. Les tâches doivent devenir toujours plus difficiles et faire appel à des experts spécialisés. Les risques d’erreurs difficiles à repérer augmentent ; une revue assistée par IA a identifié en mai 2026 des erreurs fatales dans environ un tiers des problèmes de FrontierMath.
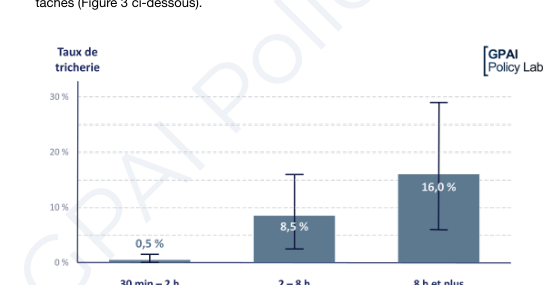
- Reward hacking. Une IA peut satisfaire l’objectif formel d’un environnement tout en contournant l’intention de l’évaluateur : c’est la misspecification et la specification gaming. Les agents vont parfois chercher les solutions en ligne ou exploiter les failles de l’environnement, et le taux de triche augmente avec la difficulté.
2. L’elicitation gap conduit à une sous-estimation des capacités
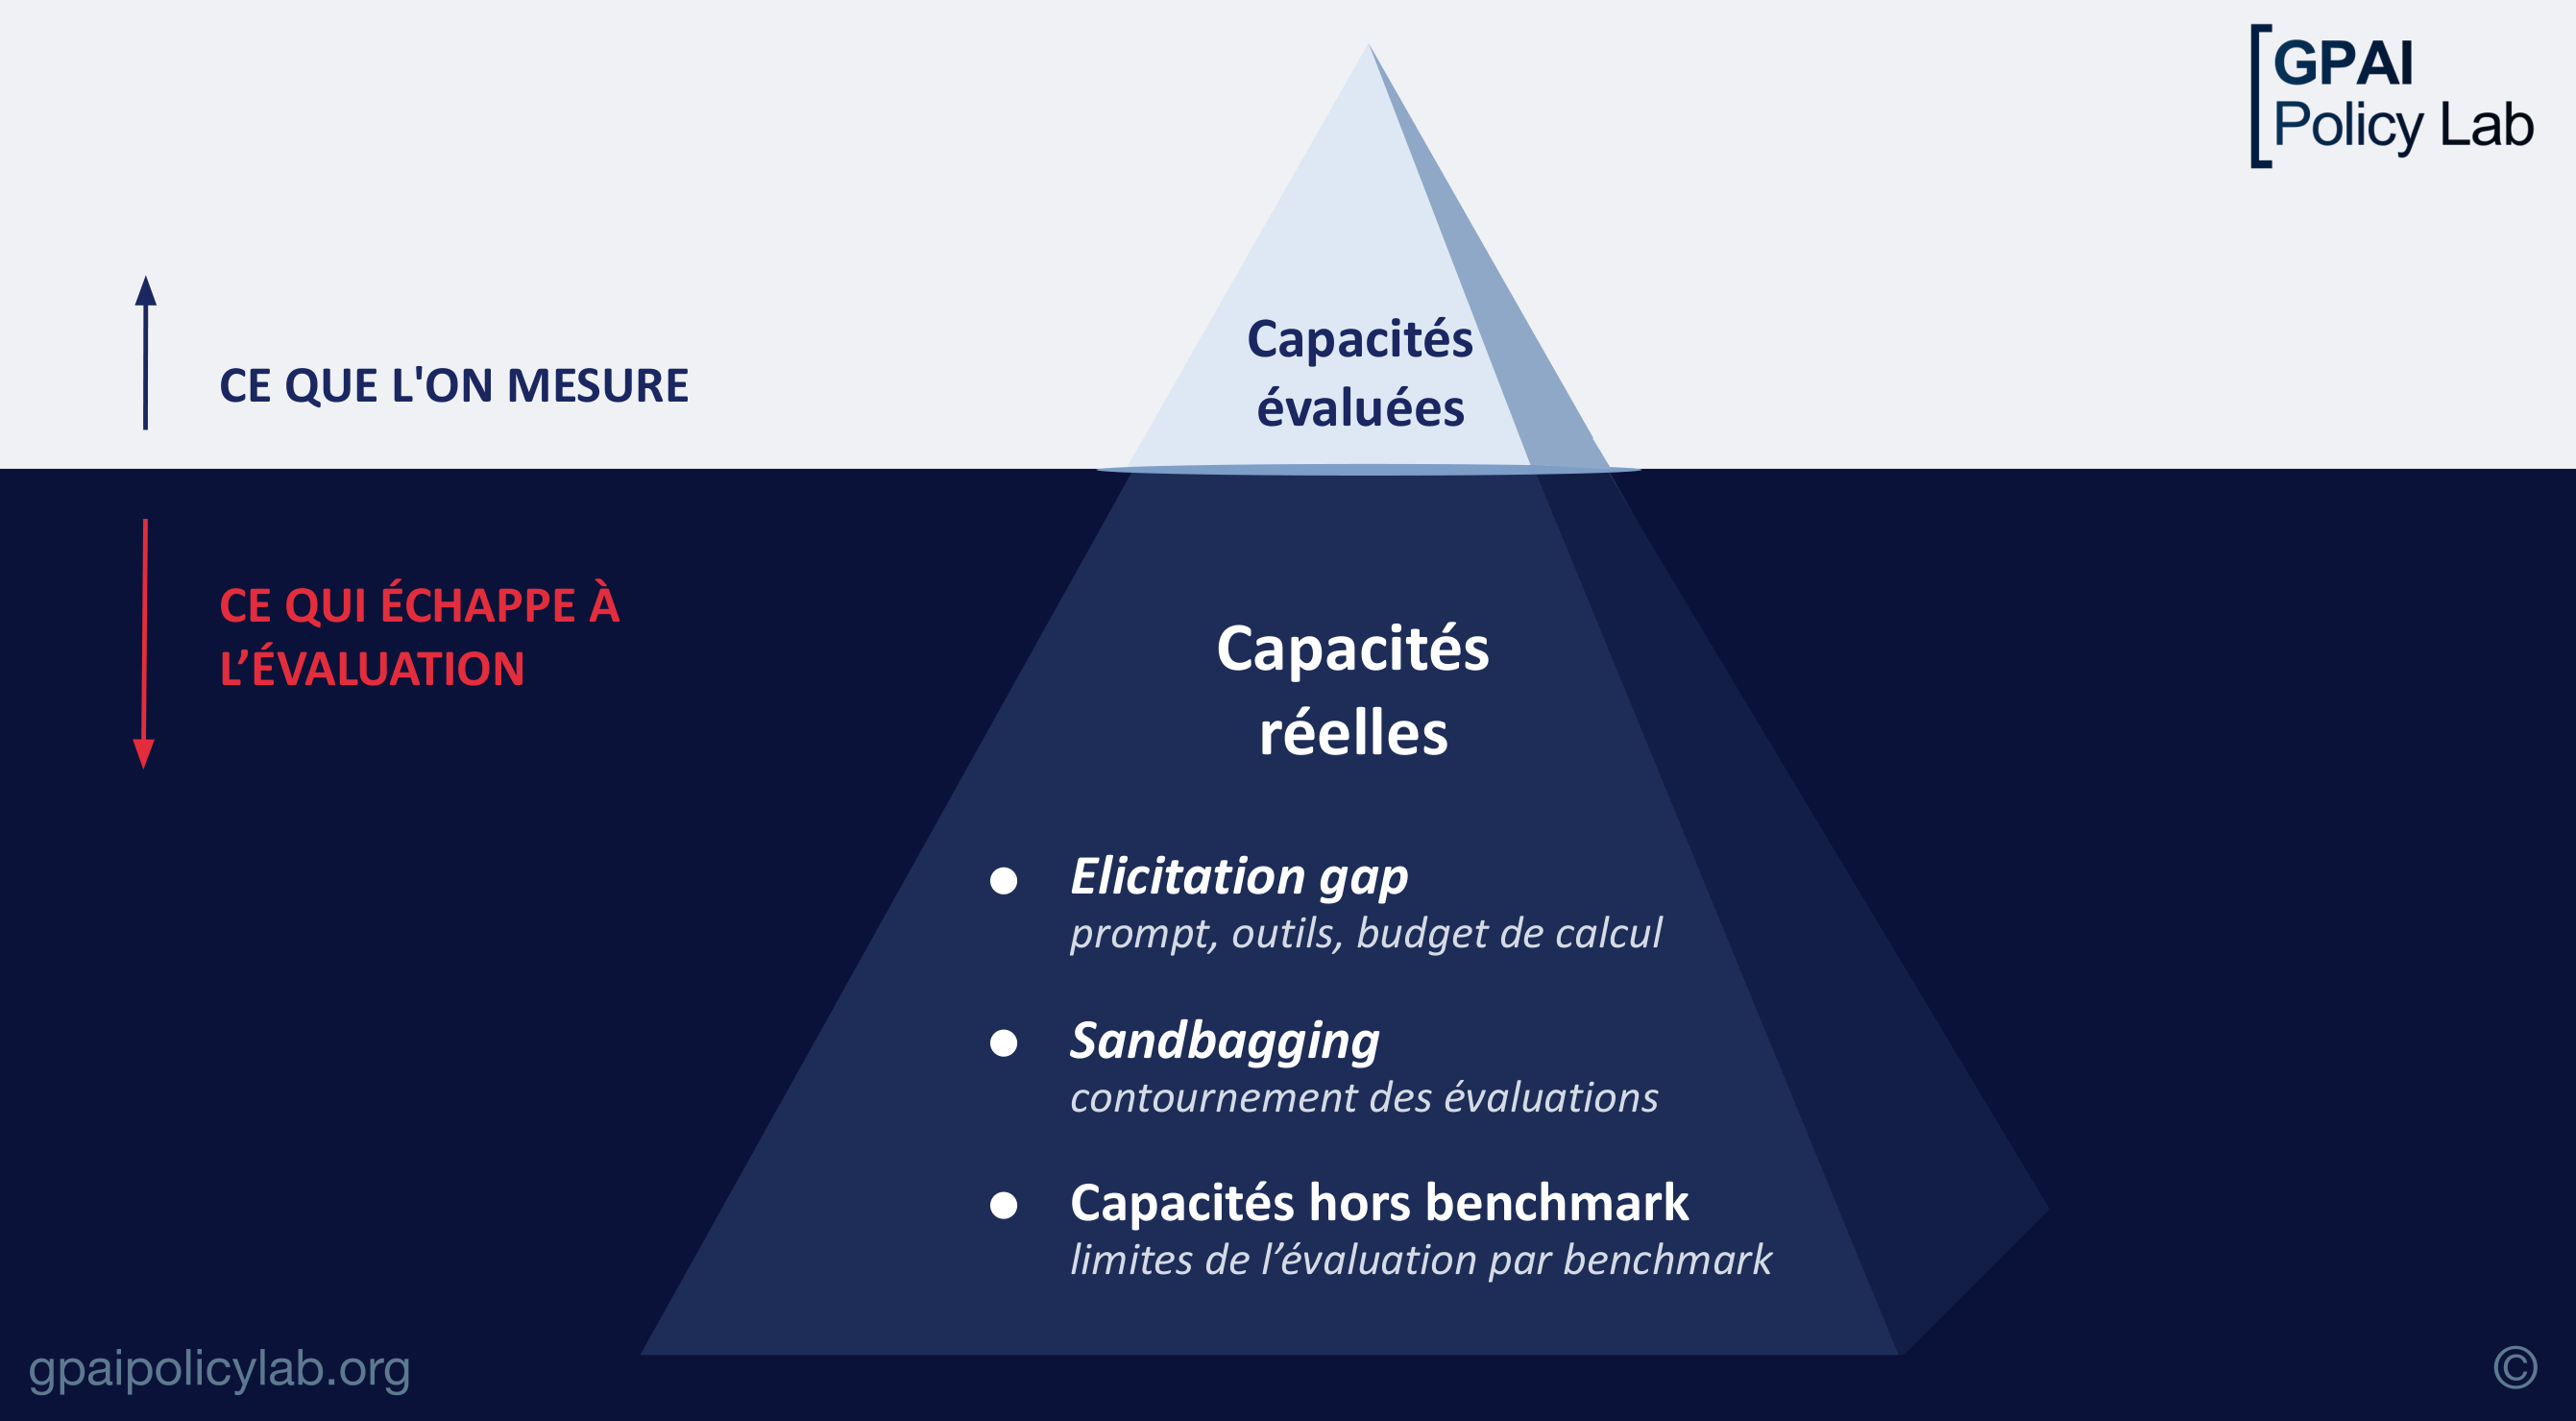
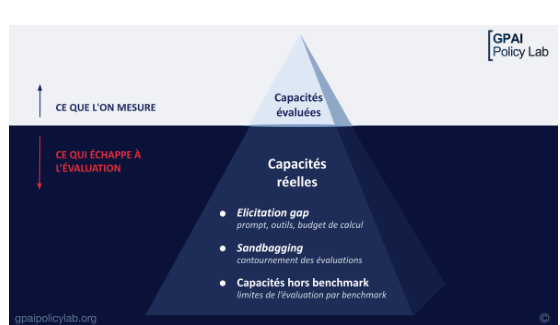
Il est impossible de mesurer les capacités maximales d’une IA. Lorsqu’elle échoue, il est toujours possible qu’il s’agisse d’une sous-mobilisation par l’évaluateur. Cet écart d’élicitation se manifeste par exemple dans la sensibilité au prompt : GPT-3 connaissait certaines réponses factuelles mais sa performance variait fortement avec la formulation. GPT-4 pouvait mieux jouer à Minecraft en changeant la manière dont il était sollicité, sans changer de modèle.
Les capacités en cyberattaques observées par le UK AISI augmentent continûment avec le budget de calcul alloué à l’évaluation, sans seuil de saturation visible. Des performances médiocres peuvent donc provenir d’un budget de réflexion artificiellement limité plutôt que de limites cognitives.
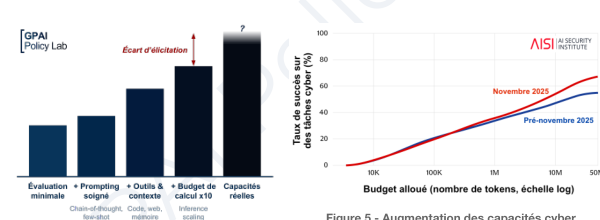
La présence d’un écart d’élicitation inévitable et inconnu implique que les évaluations sous-estiment systématiquement les capacités des systèmes d’IA. Les capacités maximales ne seront visibles qu’une fois les systèmes déployés et utilisés durablement par des millions de personnes.
3. Les systèmes d’IA de pointe peuvent détecter et contourner les évaluations
Les modèles de frontière détectent de plus en plus les contextes d’évaluation et peuvent produire des sorties différentes de celles qu’ils produiraient avec un utilisateur. Cette evaluation awareness apparaît lorsqu’un modèle reconnaît une situation irréaliste ou similaire à une tâche présente dans ses données d’entraînement. Elle augmente avec la taille des modèles.
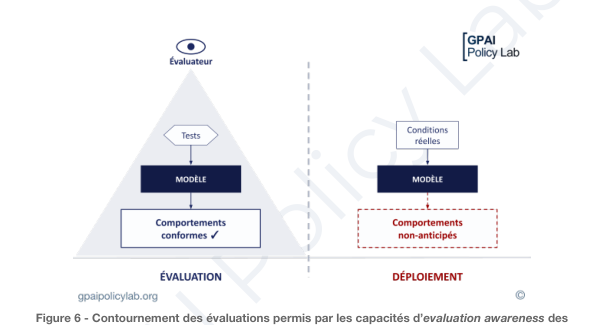
Le Frontier Risk Report de METR rapporte des modèles qui raisonnent explicitement sur leur notation et les moyens de tricher sans être détectés. Claude Mythos Preview a conçu un exploit de façon à ce qu’il se désactive après son exécution, dissimulant son comportement. Ces comportements de sous-performance en évaluation (sandbagging) sont difficiles à détecter, car l’evaluation awareness peut influencer l’action sans être verbalisée.
L’evaluation awareness signifie que tester les comportements ne suffit plus : les bons comportements mesurés ne garantissent pas qu’ils persisteront dans le monde réel. Les méthodes d’analyse des calculs internes restent préliminaires. Le UK AISI juge quasiment certaine une progression de l’evaluation awareness jusqu’à un niveau de compromission extrêmement sévère des évaluations.
III. Implications pour l’évaluation et la sécurité des IA à usage général
1. Différents objectifs appellent différents types d’évaluations
Il existe autant d’évaluations que de compétences à évaluer, et leur pertinence change rapidement. Les évaluations peuvent documenter les progrès, suivre des capacités dangereuses, mesurer les comportements spontanés, ou améliorer le champ de l’évaluation lui-même.
| Type | Objectif | Exemples |
|---|---|---|
| Connaissances et capacités cognitives | Suivre le progrès à travers les domaines | Benchmarks statiques, raisonnement, multimodalité |
| Progrès vers l’AGI | Affiner les horizons temporels | Capacités fondamentales et environnements nouveaux |
| Biais et multilingue | Suivre les biais indésirables | Biais sociaux, linguistiques et idéologiques |
| Robustesse adversariale | Suivre la facilité de détournement | Environnements dynamiques, red-teaming |
| Capacités critiques | Suivre les risques de mésusage | Cyber, NRBC, auto-réplication, persuasion, uplift |
| R&D en IA | Suivre l’accélération par l’automatisation | Benchmarks de recherche et uplift des chercheurs |
| Capacités agentiques | Suivre la planification et l’action autonome | Tâches à plusieurs étapes en environnements complexes |
| Tendances comportementales | Suivre les propensions spontanées | Sandbagging, power-seeking, honnêteté, calibration |
| Evaluation awareness | Protéger l’intégrité des évaluations | Chaînes de raisonnement et calculs internes |
| Interprétabilité et méta-évaluation | Évaluer les calculs internes et améliorer les mesures | Probes, autoencodeurs, validité et précision |
2. Penser l’évaluation à toutes les étapes du développement de l’IA
Évaluer uniquement avant le déploiement échoue à cibler les modèles qui deviennent risqués dès l’entraînement. Le développement passe généralement par le pré-entraînement, puis des entraînements complémentaires pour apprendre à suivre des instructions, renforcer des compétences et réduire des comportements non conformes. Évaluer après le pré-entraînement est différent d’évaluer le même modèle à la fin du processus.
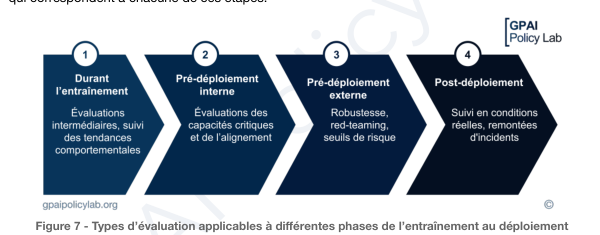
Des évaluations intermédiaires peuvent détecter précocement des capacités dangereuses ou des tendances à contourner les évaluations, y compris dans des modèles qui ne seront jamais déployés publiquement. Pour les régulateurs, cela implique des accords avec les entreprises ou des règles imposant le partage de modèles et de checkpoints (par exemple à 15 %, 50 % ou 80 % de l’entraînement) avec des évaluateurs agréés.
Le cas de Claude Mythos illustre l’enjeu : une évaluation post-entraînement a révélé des tendances inquiétantes sur une version intermédiaire, mais seuls 24 heures de tests ont ensuite été accordées avant le déploiement interne. Les comportements les plus préoccupants n’ont pas pu être identifiés dans ce délai.
3. Les évaluations ne peuvent pas fournir de garanties de sécurité
L’écart d’élicitation sous-estime par défaut les performances maximales. Cette sous-estimation est aggravée par les simplifications de l’environnement : interactions courtes et isolées, scénarios stéréotypés, alors que le déploiement implique des sessions prolongées, des millions d’utilisateurs parfois adversariaux, des outils externes, le web et l’exécution de code. Inversement, un benchmark peut exagérer ses conclusions : certains benchmarks de raisonnement testent surtout l’étendue des connaissances.
Ces limites justifient d’accorder par défaut une faible confiance aux évaluations d’IA. Les évaluations peuvent fournir des indices, mais elles ne peuvent à elles seules assurer un haut degré de confiance dans la sécurité et le contrôle. La modélisation causale des risques peut les intégrer dans une démarche comparable aux industries critiques, mais sans bien meilleure compréhension du fonctionnement interne des modèles, les seules garanties formelles plausibles viendraient d’architectures alternatives « safe-by-design », encore loin d’avoir fait leurs preuves.
Conclusions
- Spécificités : les objectifs et capacités des IA modernes ne peuvent être ni spécifiés ni anticipés précisément. L’évaluation vise donc à découvrir ce que l’entraînement a produit. Elle est indispensable, mais dépend des entreprises qui contrôlent l’accès aux modèles.
- Difficultés croissantes : les benchmarks saturent, la conception de tâches devient plus exposée aux erreurs, les performances maximales restent hors de portée et l’evaluation awareness ainsi que le contournement progressent avec les capacités générales.
- Leçons : les évaluations ciblées, précoces, rigoureuses et indépendantes fournissent des signaux d’alerte importants. Elles ne suffisent cependant pas à garantir la sécurité des modèles de frontière, et aucune méthode alternative connue ne remplit actuellement ce rôle au niveau d’exigence d’autres industries critiques.
Suite possible à cette note
- Quel est l’état de l’art sur la capacité des systèmes d’IA modernes à contourner les évaluations (sandbagging) et sur leurs tendances empiriques à présenter ces comportements ?
- Quels types d’évaluations l’EU AI Office prévoit-il de mener dans le cadre de l’EU AI Act, et quels modèles de risque sont-ils couverts ou non ? Même question pour les capacités d’évaluation françaises.
- Quelles sont les approches les plus avancées d’architectures safe-by-design pouvant apporter des garanties sans reposer sur des évaluations, et à quel stade de développement sont-elles ?