Suivre les progrès de l’IA sur 18 dimensions cognitives issues de la psychométrie
Août 2026|Auteur(s) : GPAI Policy Lab
Quand une IA saura-t-elle faire tout ce qu’un humain peut faire ?
Nous ne pourrons répondre à cette question tant que nous ne disposerons pas d’une échelle de capacité commune, interprétable, et qui ne sature pas aussi vite que la plupart des benchmarks actuels. Notre billet précédent ancrait l’échelle Rosetta Stone (Epoch Capabilities Index) dans des niveaux d’expertise humaine, mais se heurtait au problème qu’un axe de capacité unique ne rend pas compte de la progression hétérogène des IA (jagged frontier). Les horizons temporels mesurés par l’organisation METR offrent bien une échelle indépendante de la population évaluée, non bornée et compréhensible, mais ramènent l’ensemble des formes de difficulté à un unique indicateur, la durée de la tâche.
Ce billet s’appuie sur un article de Zhou et al. (que nous appellerons l’article ADeLe), publié dans Nature, qui propose une approche multidimensionnelle avec 18 échelles interprétables, indépendantes de la population de modèles évalués, et non saturables. Nous utilisons les scores publiés pour retracer l’évolution des capacités cognitives des modèles depuis 2022, et nous y ajoutons des repères humains.
En bref
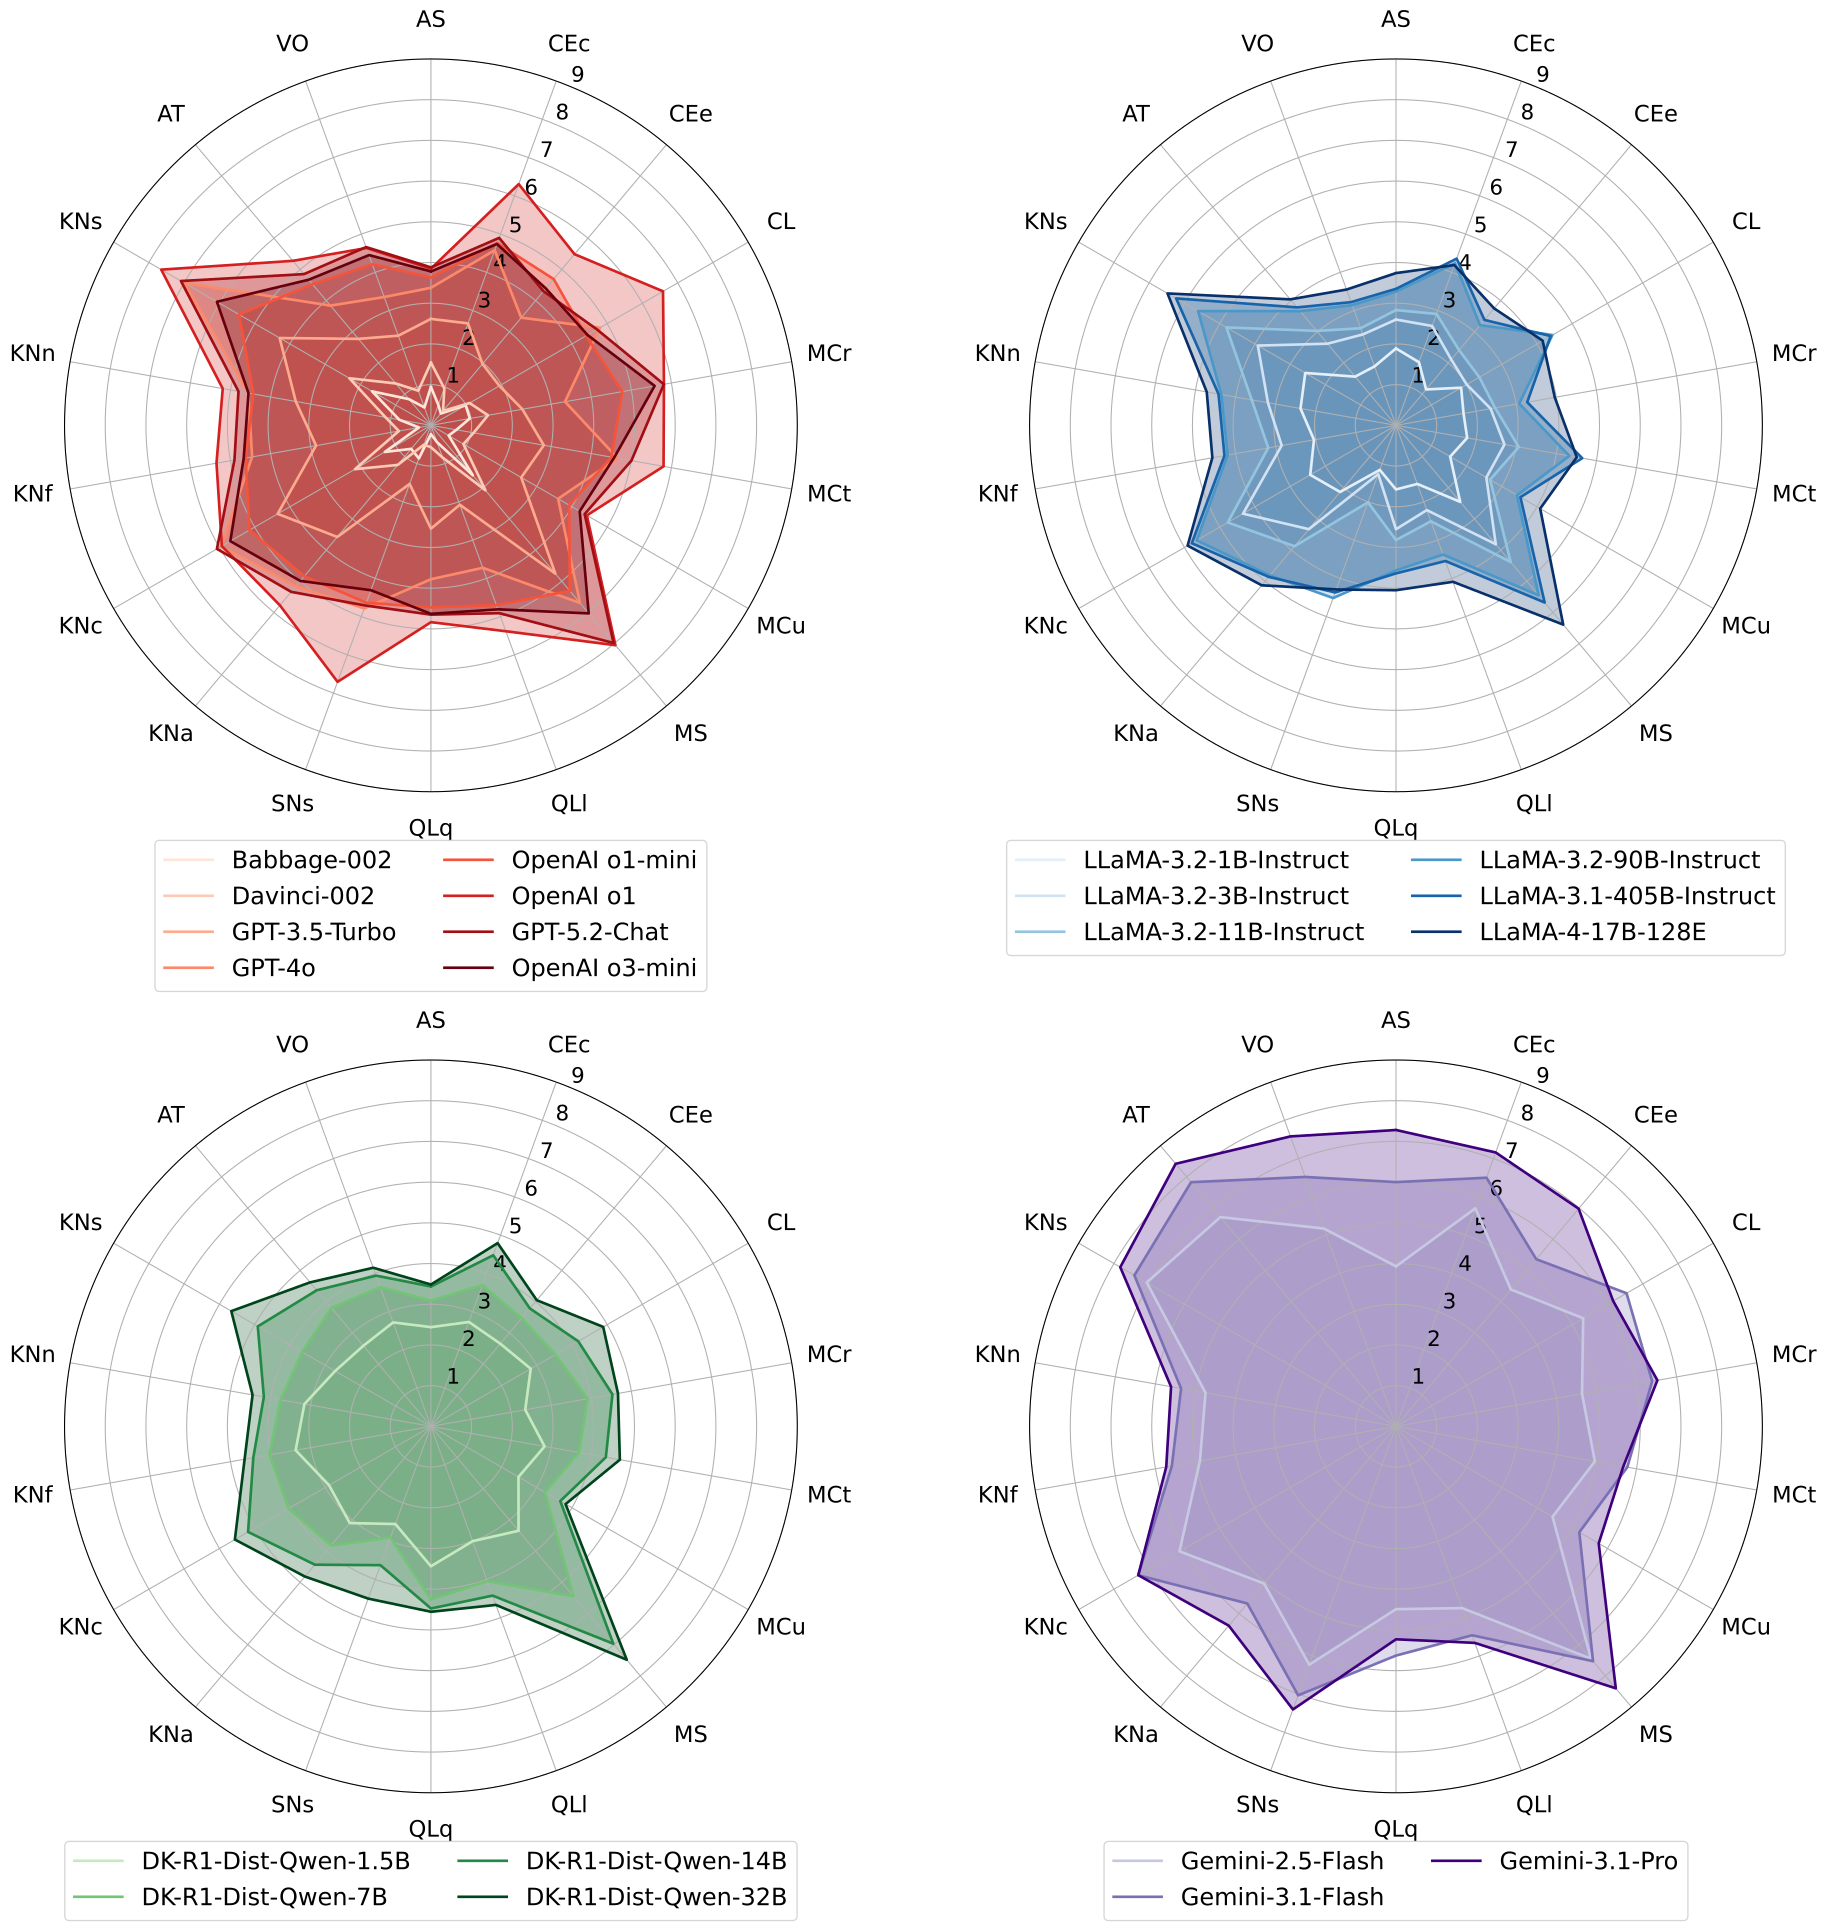
- Le corpus ADeLe rassemble 16 108 questions issues de 63 tâches et 20 benchmarks. Chaque question a été annotée sur 18 dimensions cognitives (raisonnement quantitatif, modélisation d’autrui, connaissances en sciences formelles, etc.), avec un niveau de difficulté de 0 à 5+ par dimension. Une fois un sujet (IA ou humain) évalué sur ces questions, ces échelles fournissent un profil de capacité. Les auteurs ont produit ces profils pour 21 modèles d’IA.
- Nous croisons ces profils avec les dates de sortie des modèles, isolons la frontière de capacité pour chaque groupe de dimensions, et ajustons une régression affine bayésienne sur cette frontière. Grâce aux données partagées par Peter Romero (premier auteur d’un article de suivi consacré aux références humaines), nous établissons également des repères humains à partir de 183 questions TIMSS Grade 8, posées dans le monde entier à des élèves de 13 à 14 ans.
- Résultats principaux :
- Les modèles progressent de façon continue sur toutes les dimensions observables, sans aucun signe de plafonnement ni de changement de régime.
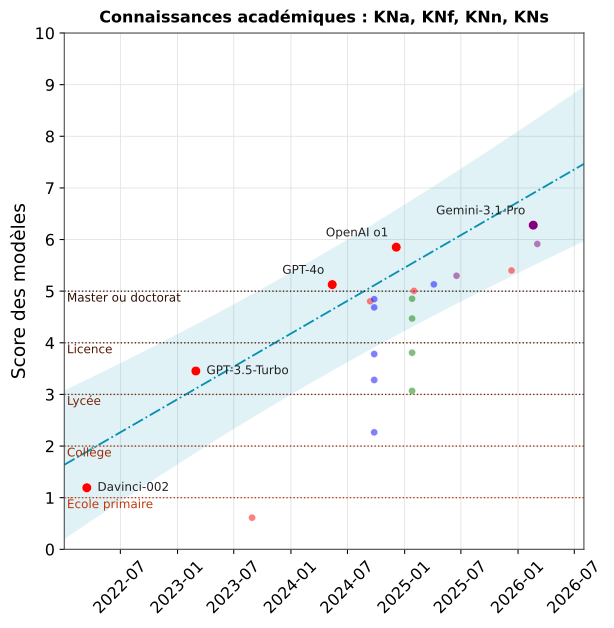
- Entre mi-2023 et mi-2024, les modèles de frontière ont dépassé le niveau de bons élèves de 13-14 ans (~top 20 %) sur l’ensemble des dimensions où la comparaison était possible.
- Depuis 2024-2025, les modèles de frontière disposent de connaissances et capacités suffisantes pour la majorité des questions de niveau 5, soit des connaissances « typiquement acquises en master ou au-delà ».
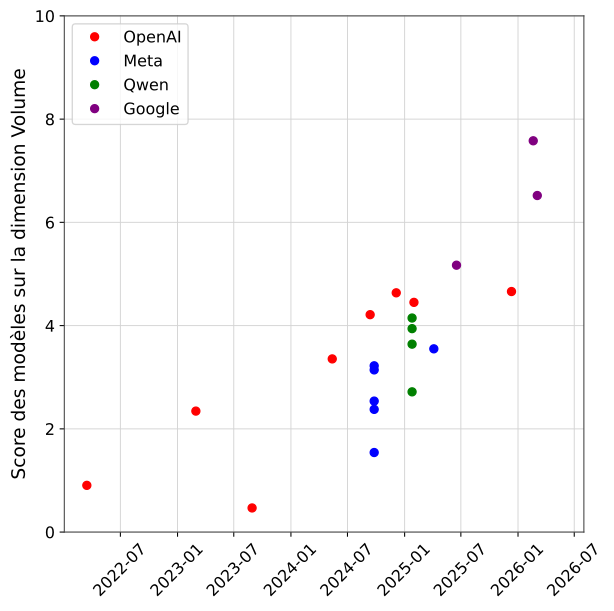
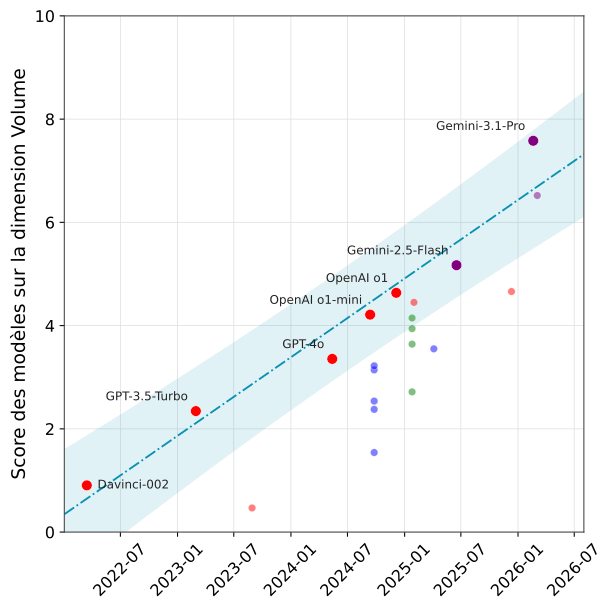
- La dimension Volume, proportionnelle au logarithme du temps qu’un humain pleinement compétent mettrait à traiter la tâche, progresse linéairement. La durée des tâches réalisables croît donc exponentiellement, ce qui corrobore par une méthode indépendante les tendances d’horizon temporel mesurées par METR.
- Ces résultats affaiblissent l’hypothèse selon laquelle le progrès des IA pourrait être bloqué par des limites durables sur certaines capacités cognitives.
- Trois limites accompagnent ces conclusions. Le corpus ADeLe ne contient pas de questions annotées au-delà du niveau 5, ce qui fragilise les compétences estimées pour les modèles les plus capables. Les évaluations sont exclusivement textuelles, sans dimension dédiée aux capacités agentiques ou multimodales, et sans accès à des outils externes. Enfin, plusieurs familles de modèles sont absentes, notamment Claude, ce qui conduit à sous-estimer la position réelle de la frontière.
Contexte sur l’article ADeLe : pourquoi une échelle multidimensionnelle
ADeLe, pour Annotated-Demand-Levels, repose sur deux idées.
Idée 1 : ce qu’un benchmark mesure réellement peut être établi à partir de variables latentes issues de la psychométrie
Le point de départ de l’article ADeLe est que les benchmarks ne mesurent pas ce qu’ils annoncent mesurer. Une de ses analyses documente que sur 14 benchmarks examinés, neuf d’entre eux ne mesurent aucune des dimensions cognitives revendiquées par leurs auteurs, et pour les autres la correspondance n’est que très partielle. Les benchmarks de « raisonnement », en particulier, mesurent souvent des compétences hors de leur périmètre annoncé (défaut de spécificité), ou ne mesurent pas celles que leur périmètre annoncé implique (défaut de sensibilité). Ce constat invite à la prudence dans l’interprétation des scores de benchmarks, et plaide pour leur préférer des dimensions cognitives explicites du type de celles d’ADeLe.
Plutôt que de faire confiance à ces revendications, les auteurs procèdent en sens inverse. Ils sélectionnent d’abord 18 dimensions cognitives issues de la littérature psychométrique (voir Annexe 1), chacune assortie d’une définition, d’une échelle de difficulté allant de 0 à 5+ et d’exemples de questions pour chaque niveau. Ils s’en servent ensuite pour déterminer ce que chaque benchmark sollicite effectivement.
Encadré 1 - À quoi ressemble une échelle de difficulté
Les auteurs fournissent une définition détaillée et plusieurs exemples de questions pour chacun des niveaux 0 à 5+. Si l’on prend un échantillon pour la dimension « raisonnement spatio-physique », définie comme la compréhension des relations spatiales entre objets et la prédiction de leurs interactions physiques :
- Niveau 0 (dimension non sollicitée) : copier un texte d’un document vers un autre sans tenir compte de la mise en page.
- Niveau 3 (difficulté moyenne) : se représenter mentalement la trajectoire d’une balle lancée en cloche et prédire son point de chute, en tenant compte d’une courbure simple et d’un vent léger.
- Niveau 5 (difficulté très élevée) : rédiger ou interpréter des instructions techniques d’assemblage d’un dispositif mécanique complexe, ce qui suppose de décrire précisément des relations spatiales et un ordre de montage en trois dimensions.
Les dimensions de connaissances académiques suivent une structure commune, les niveaux 1 à 5 correspondant respectivement à des savoirs acquis à l’école élémentaire, au collège, au lycée, en premier cycle universitaire, puis en master ou au-delà.
En pratique, 16 108 questions provenant de 63 tâches issues de 20 benchmarks ont été annotées le long des 18 dimensions par un LLM annotateur, formant le corpus ADeLe v1.0. L’accord entre annotateurs humains, ainsi qu’entre annotateurs humains et LLM annotateur, a été vérifié sur un sous-ensemble. Chaque benchmark dispose ainsi d’une distribution de difficulté qui indique, pour chaque dimension, la proportion de ses questions relevant de chaque niveau. Cette distribution ne dépend d’aucune population de sujets, et tout ensemble de questions annotées dispose d’une distribution de difficulté.
Idée 2 : les variables latentes de difficulté fournissent des dimensions naturelles pour évaluer des capacités cognitives
Une échelle de difficulté des questions se lit également comme une échelle de compétence des sujets. Chaque modèle d’IA est interrogé sur chaque question, ses réponses sont classées comme correctes ou incorrectes par un LLM juge disposant des réponses de référence, puis un score de capacité est calculé par dimension à partir de ces résultats et des annotations de difficulté.
Encadré 2 - Comment lire un score ADeLe
Une heuristique utile est qu’un sujet dont le score est s sur la dimension D réussit environ une question sur deux parmi celles dont le niveau de difficulté vaut s sur D, et ne dépasse pas s sur les autres dimensions. Un score de 5 en connaissances en sciences formelles signifie donc que le modèle traite correctement environ la moitié des questions requérant des connaissances de niveau master, dès lors qu’elles n’exigent rien d’exceptionnel par ailleurs. Un niveau 5 sur la dimension Volume correspond à une tâche demandant au moins 16 heures de travail à un humain pleinement compétent.
Deux résultats de l’article justifient de traiter ces dimensions comme des variables de capacité. D’abord, pour prédire si un modèle donné répondra correctement à une question donnée, les annotations ADeLe font aussi bien ou mieux que les méthodes alternatives, avec une robustesse nettement supérieure dans les configurations hors échantillon (out-of-sample). Ensuite, les dimensions progressent de manière cohérente avec leurs descriptions : les dimensions de connaissance suivent principalement la taille du modèle, tandis que celles représentant le raisonnement quantitatif et logique, la conceptualisation, l’apprentissage et l’abstraction, ainsi que la modélisation d’autrui, sont renforcées chez les modèles d’IA avec chain-of-thought qui consacrent davantage de calcul à l’inférence. En isolant l’effet de la taille du modèle, les auteurs observent des rendements décroissants sur le score de capacité.
L’intérêt de ce cadre pour le suivi des capacités tient à trois propriétés :
- les scores d’un modèle ne changent pas lorsqu’on ajoute d’autres modèles à l’évaluation, contrairement à l’Epoch Capabilities Index ;
- les échelles ne saturent pas, par construction, puisqu’elles décrivent la difficulté des items et non le taux de réussite ;
- un niveau donné dans une dimension se traduit en une description concrète de ce que le modèle sait faire.
Contexte sur l’article Human Scales : ancrer les niveaux dans des références humaines
Romero et al. prolongent l’article ADeLe en cherchant à ancrer ses niveaux dans des références humaines représentatives de la population mondiale. Nous avons exploré ce que cette approche indique de la progression des capacités des IA au cours du temps, mais l’extrapolation à l’ensemble de la population humaine nous paraît encore trop fragile. Ce billet s’appuie donc sur l’article ADeLe et ne reprend aucun résultat de l’article Human Scales. En revanche, les données collectées par ses auteurs nous ont permis d’établir nos propres repères humains sans recourir à cette extrapolation.
Notre analyse
Nous procédons en trois temps.
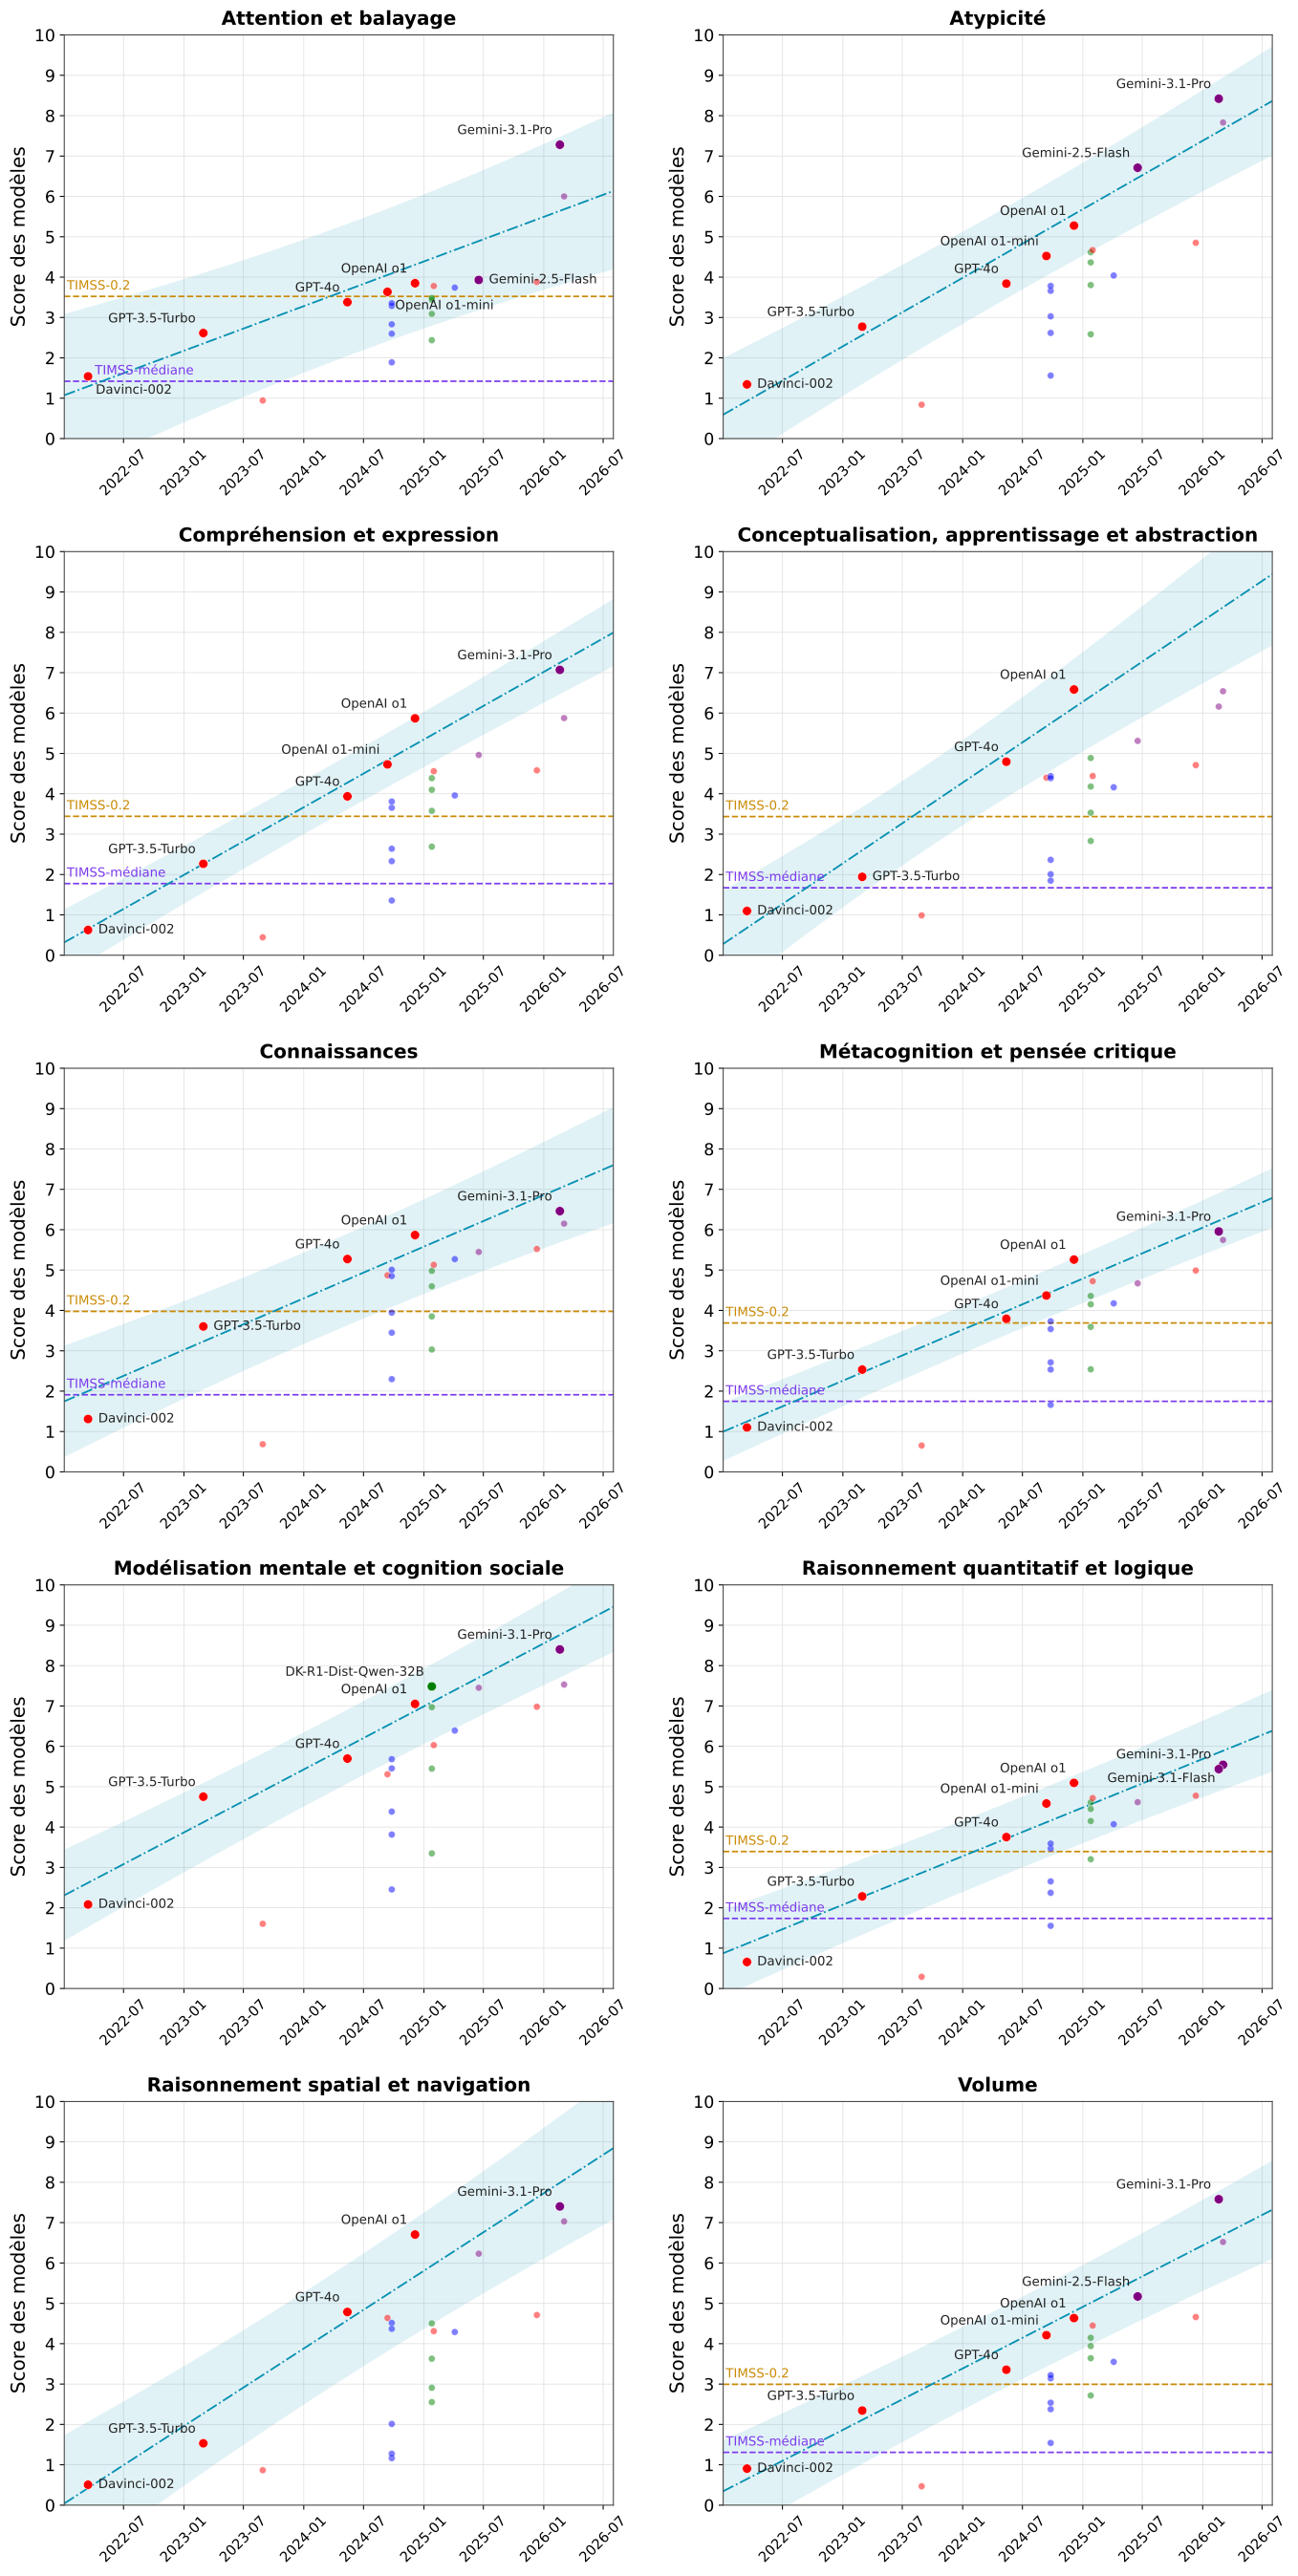
Évolution temporelle. Les 21 modèles sont associés à leur date de sortie. Les 18 dimensions sont combinées en 10 groupes, en reprenant les regroupements proposés par les auteurs. Le score d’un groupe est la moyenne harmonique des scores des dimensions qui le composent. Ce regroupement est nécessaire pour que le calcul ultérieur des repères humains ne souffre pas d’un trop grand nombre de données manquantes.
Frontière et tendance. Pour chaque groupe, la frontière rassemble les modèles dont le score est supérieur ou égal à celui de tous les modèles documentés sortis à la même date ou avant. Une régression affine bayésienne est ajustée sur cette frontière, dont nous représentons la moyenne a posteriori et l’intervalle de crédibilité à 95 %.
Repères humains. Nous isolons 183 questions TIMSS Grade 8 (élèves de 13-14 ans) annotées, accompagnées de leur taux de réussite international moyen. Nous définissons alors un sujet virtuel TIMSS-p, qui réussit toute question dont le taux de réussite est supérieur ou égal à p et échoue aux autres. Ce sujet virtuel dispose donc d’un ensemble de réponses correctes et incorrectes sur des questions annotées, ce qui permet de lui calculer un profil ADeLe par le même calcul que pour les modèles. Après vérifications, nous retenons les profils TIMSS-médiane (approximativement un élève médian, voir Annexe 2) et TIMSS-0.2 (approximativement un élève au top 20 %) sur 7 des 10 groupes, tracés en lignes horizontales.
Résultats
Les modèles progressent sur toutes les dimensions cognitives que le corpus ADeLe permet d’observer, sans plafonnement visible. Entre mi-2023 et mi-2024, la frontière franchit le niveau des bons élèves de 13-14 ans sur toutes les dimensions comparables. Le niveau 5 est aujourd’hui dépassé, à la fois par au moins un modèle et par la tendance sous-jacente, sur l’ensemble des dimensions.
Sur les dimensions de connaissance rattachées à un cursus scolaire, ce franchissement se lit directement en termes de niveaux d’études, puisque les paliers 1 à 5 correspondent respectivement à l’école élémentaire, au collège, au lycée, au premier cycle universitaire et au master.
La progression sur la dimension Volume indique une croissance exponentielle de la durée des tâches réalisables, répliquant les observations de METR. L’échelle Volume étant définie de manière logarithmique, avec chaque niveau correspondant à un ordre de grandeur de temps humain, la progression linéaire mesurée signifie une progression exponentielle du temps de travail humain équivalent.
Interprétation
Ces résultats ne signifient pas que les modèles dépassent déjà les humains sur toutes les tâches cognitives. D’une part, les évaluations mobilisées n’incluent que des tâches à base de texte. De l’autre, un modèle peut atteindre un niveau élevé sur chaque dimension actuellement incluse tout en échouant sur des tâches faisant appel à des dimensions rares et à l’avantage des humains. C’est ce qui explique qu’un benchmark comme SimpleBench, conçu pour exploiter cet écart, montre encore les modèles de pointe légèrement en dessous des humains.
En revanche, ces trajectoires affaiblissent l’hypothèse selon laquelle le progrès des IA pourrait être bloqué par des limites durables sur certaines capacités cognitives. Même si le profil des capacités reste irrégulier, les dimensions plus faibles progressent elles aussi continûment, et rien dans les données observées ne suggère qu’elles se stabiliseront sous le niveau humain. Le poids de cet argument reste modéré, étant donné que les scores utilisés proviennent d’évaluations textuelles et que les auteurs eux-mêmes appellent à étendre le cadre aux modèles agentiques.
Limites
- Annotations restreintes. ADeLe v1.0 ne contient pas de questions annotées au-delà du niveau 5. Les meilleurs modèles sont donc évalués sur leurs scores à des niveaux inférieurs à leur limite réelle, ce qui oblige à extrapoler certaines capacités au-delà de la difficulté maximale annotée.
- Texte uniquement. Les questions et réponses sont exclusivement textuelles, sans dimensions pour les usages agentiques, multimodaux ou avec des outils externes.
- Les modèles manquants. L’absence de plusieurs familles de modèles, dont Claude, produit une sous-estimation attendue de la position de la frontière, puisque l’ajout d’un modèle ne peut que la relever. L’effet sur l’analyse globale reste vraisemblablement limité, une part importante des modèles de frontière étant incluse.
- Le traitement dimension par dimension. Le calcul d’un profil sélectionne, pour chaque dimension, les questions dont le niveau sur cette dimension domine les autres, puis ajuste une sigmoïde à deux paramètres sur la probabilité de réussite. Cette procédure capture mal trois phénomènes. D’abord l’irrégularité des profils : un sujet très compétent en sciences formelles et faible en sciences naturelles échouera à une question exigeant les deux (avec un peu moins de sciences naturelles), mais cet échec sera imputé aux sciences formelles, et la question sera écartée avant le calcul de son score en sciences naturelles. Ensuite les effets de compensation : une question peut être résolue par une voie que ses annotations ne reflètent pas, par exemple en connaissant directement le résultat. Enfin le cumul des difficultés : une question difficile sur une seule dimension et une question difficile sur toutes les dimensions sont traitées de façon identique dans le calcul du score, alors que la seconde est manifestement plus dure.
- La régression linéaire. Elle ne peut pas capturer un changement de régime. Au vu de la qualité des ajustements obtenus, nous estimons que les tendances observées sont effectivement linéaires sur la période. La dimension Attention and Scan fait exception, la progression y est visible mais moins régulière, et la droite en rend moins bien compte. Cette hypothèse de linéarité devra être réexaminée à mesure que de nouveaux modèles seront évalués.
Nous nous attendons à ce que des méthodes de calcul de profil plus fines conduisent aux mêmes conclusions qualitatives. Ces limites importent davantage pour des analyses ultérieures qui reposeraient plus lourdement que la nôtre sur les valeurs absolues des scores.
Travaux futurs
- Évaluer davantage de modèles, en particulier les modèles de frontière passés et actuels absents de la base.
- Définir des niveaux de difficulté au-delà de 5 et ajouter les questions correspondantes, pour rendre les scores fiables dans la partie haute de l’échelle.
- Diversifier les références humaines, avec des adultes plus qualifiés, et ajouter des variables de fiabilité. Comparer des modèles à des profils de métiers permettrait d’anticiper leur possible automatisation. Quantifier la fiabilité, et non seulement le niveau moyen, permettrait d’estimer les probabilités de défaillances ou succès inattendus.
- Étendre le cadre aux configurations agentiques et multimodales, en tenant compte des échafaudages logiciels (scaffolds), ce qui soulève des difficultés méthodologiques propres.
- Traiter l’irrégularité des profils et les effets de compensation dans le calcul des scores, sans rendre le corpus plus coûteux à étendre.
Annexe 1 - Les dimensions d’ADeLe
| Code | Dimension | Description |
|---|---|---|
| AS | Attention et balayage | Localiser ou suivre des éléments précis dans un flux d’information. |
| CEc | Compréhension verbale | Comprendre un texte ou le contenu sémantique d’autres représentations. |
| CEe | Expression verbale | Produire et articuler des idées ou des contenus sémantiques. |
| CL | Conceptualisation, apprentissage et abstraction | Former des concepts, raisonner par induction et analogie, généraliser. |
| MCr | Identification de l’information pertinente | Distinguer ce qui contribue à la résolution de la tâche de ce qui ne contribue pas. |
| MCt | Pensée critique | Contrôler et réguler plusieurs processus de raisonnement. |
| MCu | Calibration des connaissances | Reconnaître les limites de ses propres connaissances. |
| MS | Modélisation d’autrui et cognition sociale | Représenter croyances, désirs et intentions d’autres agents. |
| QLl | Raisonnement logique | Appliquer règles, procédures et algorithmes à des prémisses. |
| QLq | Raisonnement quantitatif | Manipuler quantités, nombres et relations numériques. |
| SNs | Raisonnement spatio-physique | Comprendre les relations spatiales et prédire des interactions physiques. |
| KNa | Connaissances en sciences appliquées | Médecine, droit, gestion, ingénierie hors informatique, etc. |
| KNc | Connaissances courantes | Savoirs acquis par l’expérience quotidienne et les médias. |
| KNf | Connaissances en sciences formelles | Mathématiques, logique, informatique, statistiques. |
| KNn | Connaissances en sciences naturelles | Physique, chimie, biologie, astronomie, sciences de la Terre. |
| KNs | Connaissances en sciences sociales | Histoire, psychologie, sociologie, littérature, philosophie. |
| AT | Atypicité | Rareté de la tâche, improbabilité qu’elle figure dans les sources courantes (internet, manuels, examens). |
| VO | Volume | Temps qu’un humain compétent mettrait à lire et traiter la tâche, en conditions idéales et sans interruption. |
| UG | Improbabilité de deviner | Probabilité d’erreur en suivant les indices apparents ou au hasard. |
L’improbabilité de deviner (UG) est comptabilisée à part, ce qui porte le total à 19 lignes pour 18 dimensions cognitives. Les niveaux de difficulté vont de 0, la dimension n’est pas sollicitée, à 5, sollicitation très élevée.
Annexe 2 - Construction des repères humains
Les données proviennent de l’article de suivi consacré aux références humaines (Romero et al.), dont les auteurs visent une extrapolation à la population mondiale. Nous ne reprenons pas cette extrapolation, que nous jugeons encore trop fragile, et nous limitons aux données brutes qu’ils ont collectées.
Nous retenons 183 questions issues de TIMSS Grade 8, enquête internationale portant sur des élèves de 13 à 14 ans, pour lesquelles nous disposons à la fois des annotations de difficulté ADeLe et du taux de réussite international moyen. Le sujet virtuel TIMSS-p réussit par construction toute question dont le taux de réussite est supérieur ou égal à p. Faire varier p permet de représenter des élèves fictifs de niveaux différents, avec TIMSS-médiane correspondant approximativement à un élève médian, et TIMSS-0.2 à un élève au top 20 %. Le profil ADeLe de chaque sujet virtuel est ensuite calculé comme pour un modèle.
Deux groupes de dimensions n’ont pas pu être traités faute de données suffisantes, et les résultats d’un troisième ont été jugés trop fragiles pour être publiés.
Cette construction ne prétend pas représenter un élève réel, dont les réussites et échecs ne suivent pas un seuil déterministe sur le taux de réussite international, mais fournit un repère interprétable.
Code
Le code de nos analyses est disponible sur github.com/General-Purpose-AI-Policy-Lab/adele-extension.
Nous remercions Peter Romero pour le partage des données, qui nous a permis de conduire notre propre analyse sans reprendre à notre compte les hypothèses et résultats de l’article dont elles sont issues.
Citer ce billet
GPAI Policy Lab. « Suivre les progrès de l’IA sur 18 dimensions cognitives issues de la psychométrie. » Août 2026. https://gpaipolicylab.org/blog-4.